GlitchTip에서 Sentry로
KOIN 프론트엔드 모니터링 환경을 Sentry로 전환한 기록
프론트엔드 모니터링을 Sentry로 옮기고 다듬기
1/ 3목록 보기
- 01GlitchTip에서 Sentry로
- 02Sentry를 운영에 활용하기
- 03Sentry에 어떤 데이터를 보낼까
KOIN은 프론트엔드 모니터링을 위해 Self-hosting GlitchTip을 사용하고 있었습니다.
기존에 모니터링 툴로 GlitchTip을 선택한 이유는 여러 가지가 있었지만, 가장 큰 이유는 비용이었습니다. 동아리에서 운영하는 서비스 특성상 지속적으로 높은 비용이 발생하는 도구는 장기적으로 유지하기 어렵다고 판단했습니다.
GlitchTip은 비교적 가볍고 셀프 호스팅이 가능해 운영 비용을 낮출 수 있었으며, 세션 리플레이와 같은 일부 고급 기능은 부족하더라도 당시 가장 필요했던 에러 추적이라는 목적을 충분히 달성할 수 있는 도구였습니다.
하지만 시간이 지나며 셀프 호스팅이라는 장점이 오히려 단점으로 다가오기 시작했습니다.
인프라 지식을 갖춘 일부 프론트엔드 팀원들에게 유지보수 부담이 집중되었으며, 모니터링을 하기 위해 도입한 도구였지만 정작 모니터링 도구 자체의 서버 상태와 배포, 데이터베이스까지 관리해야 했습니다.
마침 여러 서비스를 함께 운영하던 EC2 인스턴스를 정리하게 되면서 GlitchTip의 운영 위치도 다시 고민하게 되었습니다. 백오피스나 블로그, Slack Bot 등은 각각 다른 환경으로 이전하거나 정리할 수 있었지만, GlitchTip은 PostgreSQL까지 함께 운영해야 했기 때문에 별도의 이전이 필요했습니다.
처음에는 기존 구성을 유지한 채 GlitchTip과 PostgreSQL만 Raspberry Pi로 이전하는 방향을 검토했습니다.
기존 EC2
├─ 동아리 백오피스
├─ 동아리 블로그
├─ Slack Bot
├─ GlitchTip
└─ PostgreSQL

EC2 정리 후 검토안
Raspberry Pi
├─ GlitchTip
└─ PostgreSQL
하지만 이렇게 옮기더라도 서버와 데이터베이스를 직접 관리해야 한다는 점은 달라지지 않았습니다.
굳이 Self-hosted 환경을 계속 유지해야 할까?
그래서 이번에는 GlitchTip을 어디로 옮길지를 고민하기보다, 모니터링 도구 자체를 다시 선택해보기로 했습니다.
모니터링 툴 다시 선택하기
대안을 찾는 과정에서 Sentry가 오픈소스 프로젝트를 대상으로 Open Source Sponsorship을 제공하고 있다는 것을 알게 되었습니다.
이전에도 Sentry를 검토한 적이 있었지만 당시 가장 큰 걸림돌 중 하나는 비용이었습니다. 그런데 Sponsorship을 이용할 수 있다면 이 문제가 사라졌습니다.
기능적인 측면에서도 차이가 있었습니다.
GlitchTip에서도 Error Tracking과 Performance Monitoring을 사용할 수 있었지만, Sentry에서는 여기에 Session Replay, Distributed Tracing, Release Tracking, Profiling 등 문제를 분석하기 위한 정보를 더 폭넓게 연결할 수 있었습니다.
단순히 오류가 발생한 위치를 확인하는 것에서 나아가,
- 오류가 발생하기 전 사용자가 어떤 행동을 했는지
- 해당 오류가 어떤 API 요청과 연결되어 있는지
- 하나의 요청이 여러 서비스에서 어떤 Trace로 이어졌는지
- 어떤 Release에서 오류가 처음 발생했는지
등을 함께 확인할 수 있었습니다.
즉, 새로운 기능이 많다는 점 자체보다 오류 하나를 조사할 때 확인해야 하는 문맥을 한곳에서 연결해서 볼 수 있다는 점이 더 중요하게 느껴졌습니다.
또한 GlitchTip은 Sentry SDK와 호환되는 구조였기 때문에 기존에 사용하던 SDK와 여러 설정을 그대로 활용할 수 있었습니다.
다만 기능이 더 많다는 이유만으로 바로 전환할 수는 없었습니다. 기존에 GlitchTip을 선택했던 가장 큰 이유가 비용이었던 만큼, Sentry에서도 현재 서비스 규모를 감당할 수 있는지를 먼저 확인해야 했습니다.
비용은 괜찮을까
먼저 기존 GlitchTip의 사용량을 기준으로 Sentry Sponsorship의 제공량과 비교했습니다.
GlitchTip에서 월별 사용량을 확인했을 때 전체 이벤트는 약 3~4만 건 수준이었고, 그중 실제 에러 이벤트는 월 약 200건 정도였습니다.
Sentry의 Open Source Sponsorship에서 제공하는 사용량은 다음과 같았습니다.
| 항목 | Open Source Sponsorship 제공량 | 당시 서비스 사용량 |
|---|---|---|
| Errors | 월 5,000,000건 | 월 약 200건 |
| Session Replays | 월 100,000건 | - |
| Spans | 월 1,000,000,000개 | 약 100만 개 |
| Logs | 월 5,000GB | - |
| Continuous Profiling | 월 3,000시간 | - |
| UI Profiling | 월 150시간 | - |
| Cron Monitors | 500개 | - |
| Uptime Monitors | 25개 | - |
| Attachments | 10GB | - |
에러 이벤트만 놓고 보면 월 약 200건은 500만 건의 제공량과 비교했을 때 매우 작은 수준이었습니다. 기존 사용량을 기준으로 보면 Session Replay나 Tracing 등을 새롭게 사용하더라도 당장 한도를 걱정해야 할 규모는 아니라고 판단했습니다.
또한 기존 GlitchTip을 위해 별도로 사용하던 EC2를 제거할 수 있기 때문에 SaaS로 전환하면서도 추가적인 운영 비용은 발생하지 않을 것으로 보였습니다.
결국 셀프 호스팅에 따른 관리 부담을 줄이면서 더 다양한 모니터링 기능을 활용하고, 비용 문제도 해결할 수 있다는 점에서 Sentry로 전환하기로 했습니다.
Sentry 연결하기
전환을 결정한 뒤에는 Error Tracking만 옮기는 것으로 끝내지 않았습니다.
기존 GlitchTip에서는 오류가 발생했다는 사실과 stack trace를 확인하는 것이 주된 사용 방식이었다면, Sentry에서는 문제 발생 당시의 실행 문맥까지 함께 볼 수 있도록 Tracing과 Session Replay도 활성화했습니다.
초기 설정은 다음과 같이 구성했습니다.
| 환경 | Trace | 일반 Session Replay | Error Session Replay |
|---|---|---|---|
| Production | 70% → 100% | 30% | 100% |
| Stage | 100% | 0% | 100% |
실제 코드에서는 다음과 같은 형태로 설정했습니다.
tracesSampleRate: isProduction ? 0.7 : 1.0,

replaysSessionSampleRate: isProduction ? 0.3 : 0,
replaysOnErrorSampleRate: 1.0,
초기 Sampling 비율은 문제를 분석하기에 충분한 데이터를 먼저 확보하고, 실제 사용량을 보면서 조정하는 방향으로 잡았습니다.
환경별 Sampling 전략
Production은 실제 사용자 트래픽이 지속적으로 발생하는 환경이기 때문에 처음부터 모든 데이터를 수집하기보다 사용량과 분석 가능성 사이에서 균형을 잡을 필요가 있다고 생각했습니다.
Tracing은 하나의 요청이 어느 구간에서 시간을 사용했는지를 확인하는 데 활용할 수 있습니다. 예를 들어 페이지가 느리다는 문제가 발생했을 때 단순히 전체 응답 시간이 길었다는 사실만으로는 원인을 찾기 어렵지만, Trace가 있다면 서버 처리나 API 요청 등 어느 구간에서 시간이 오래 걸렸는지를 좀 더 구체적으로 확인할 수 있습니다.
반면 모든 요청을 100% 수집하면 데이터량이 불필요하게 증가할 수 있었고, 그렇다고 Sampling 비율을 지나치게 낮추면 정작 문제를 조사할 때 필요한 Trace가 남아 있지 않을 수도 있었습니다.
그래서 Production Trace는 충분한 표본을 확보할 수 있도록 초기에는 70% 로 설정했습니다.
// 초기 Production 설정
tracesSampleRate: 0.7
이후 일정 기간 운영하면서 실제 Sentry 사용량을 확인해보니 월 전체 이벤트가 약 100만 건 수준으로 Sponsorship 제공량에 비해 충분히 여유가 있었습니다.
그렇다면 Sampling으로 일부 Trace를 놓치는 것보다 가능한 한 요청 흐름을 모두 남겨두는 편이 더 유용하다고 판단했습니다. 이에 Production Trace 수집 비율을 70%에서 100%로 조정했습니다.
// 실제 사용량 확인 후
tracesSampleRate: 1.0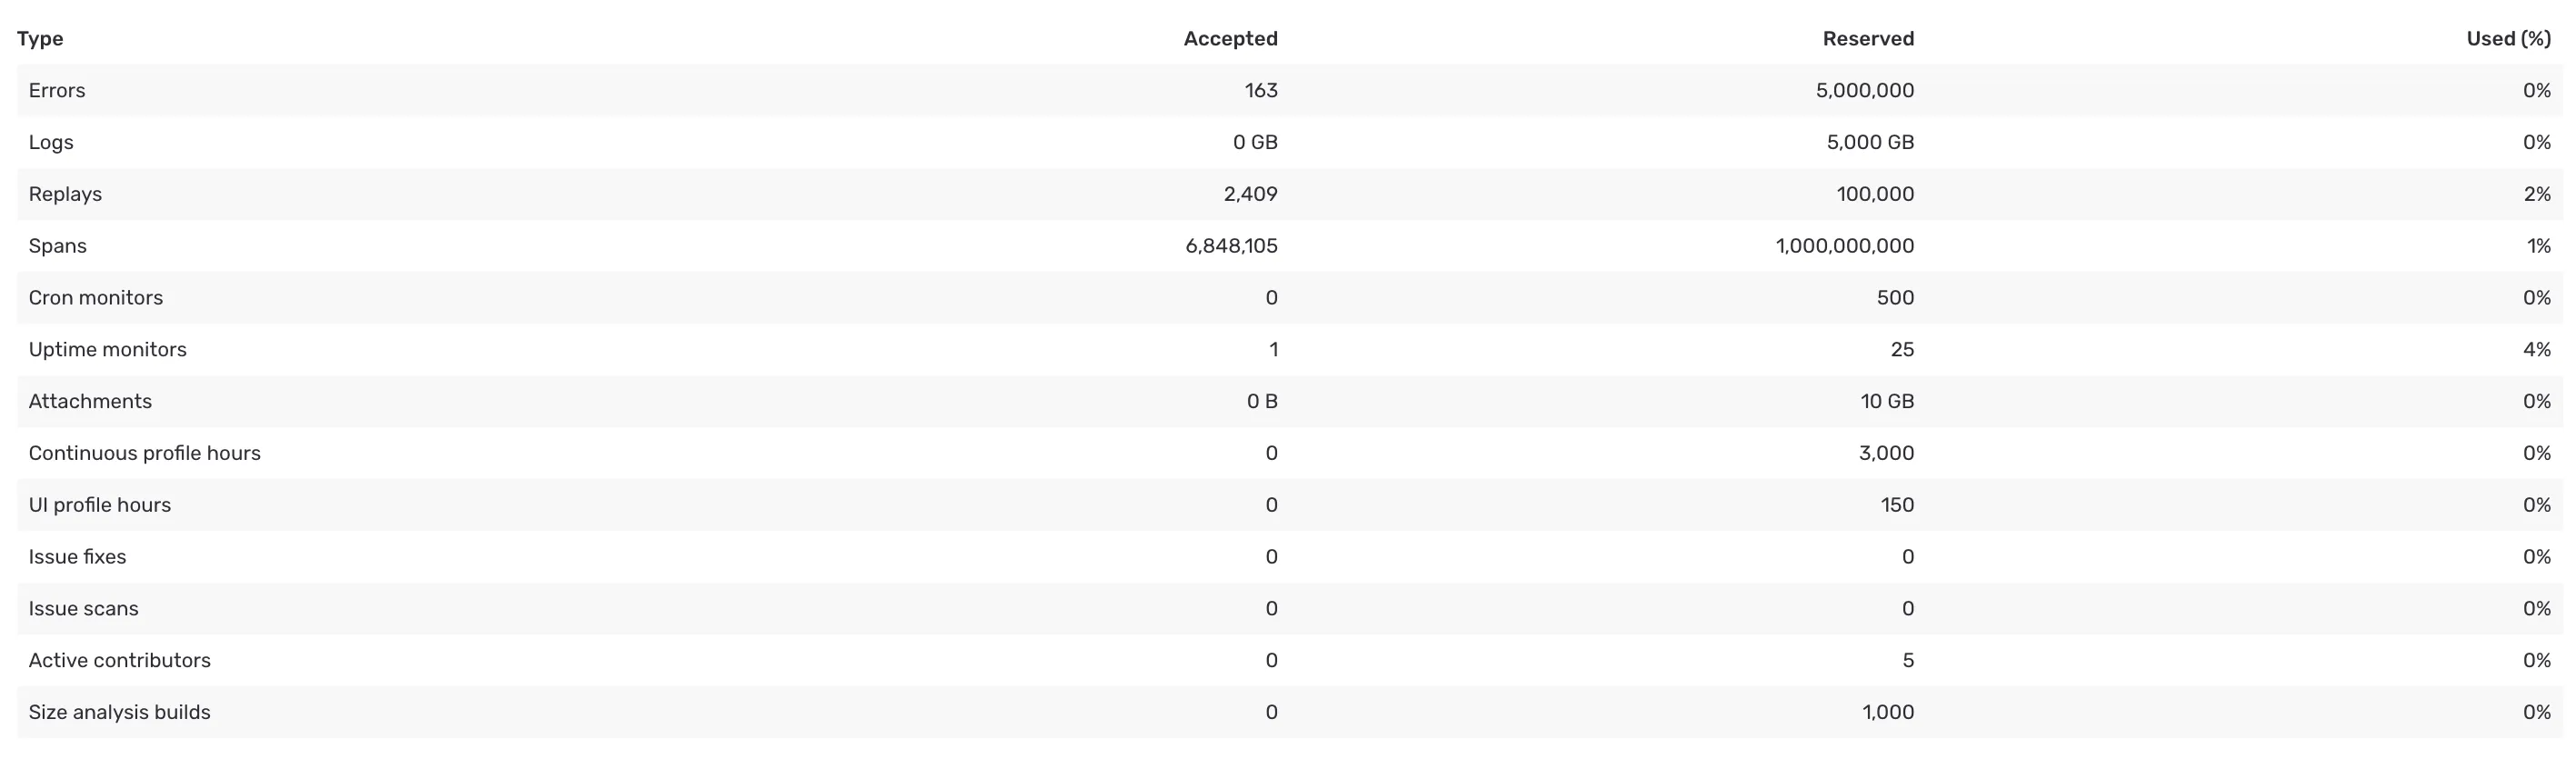
반면 일반 Session Replay는 Production에서도 30% 를 유지했습니다.
Replay의 목적은 모든 사용자의 행동을 기록하는 것이 아니라, 사용자가 어떤 흐름으로 기능을 이용했는지 확인하고 문제 상황을 재현할 수 있는 문맥을 확보하는 데 있다고 봤습니다.
정상적인 모든 세션을 저장한다고 해서 문제 분석에 얻는 정보가 같은 비율로 증가하는 것은 아니었기 때문에 일부 세션만 확보해도 충분하다고 판단했습니다.
또한 Session Replay는 사용자 화면을 기록하는 특성상 데이터 사용량뿐 아니라 개인정보도 함께 고려해야 했습니다. 따라서 Sponsorship 한도가 충분히 남아 있더라도 일반 Replay를 무조건 100%로 높이지 않고 30%를 유지했습니다.
Stage는 Production과 상황이 조금 달랐습니다. 실제 사용자보다는 개발자가 배포 결과를 확인하거나 기능을 테스트하는 용도로 사용하고 있어 트래픽 자체가 많지 않았습니다.
따라서 Sampling으로 일부 Trace를 제외해 얻는 이점이 크지 않았고, 오히려 Stage에서 문제를 재현했는데 해당 요청이 Sampling에서 제외되어 Trace가 남지 않는 상황이 디버깅에는 더 큰 손해라고 판단했습니다. 그래서 Stage에서는 처음부터 Trace를 100% 수집하도록 설정했습니다.
대신 일반 Session Replay는 0% 로 설정했습니다. Stage는 실제 사용자 행동이나 UX를 분석하기 위한 환경이 아니기 때문에 정상적으로 기능을 테스트한 모든 세션을 Replay로 저장할 필요성이 크지 않았습니다.
다만 오류가 발생한 세션은 Production과 Stage 모두 100% 수집하도록 했습니다. 일반적인 정상 세션과 달리 오류가 발생한 세션은 하나하나가 실제 문제를 분석하는 데 활용될 가능성이 높기 때문입니다.
에러 이벤트만으로는 사용자가 어떤 화면에 있었는지 → 어떤 행동을 했는지 → 어떤 상태에서 오류가 발생했는지와 같은 흐름을 파악하기 어려운 경우가 있습니다.
오류가 발생한 세션의 수 자체도 전체 정상 세션에 비해 적기 때문에 데이터량을 줄이기 위해 일부를 버리기보다는, 문제가 발생한 상황은 가능한 한 모두 남기는 것이 더 가치 있다고 판단했습니다.
결과적으로 동일한 Sampling 비율을 모든 환경에 적용하기보다 각 환경의 목적에 맞게 구성했습니다.
Production에서는 실제 사용자 트래픽과 사용량을 고려하면서도 문제 분석에 필요한 데이터를 충분히 확보했고, Stage에서는 트래픽이 적은 만큼 디버깅에 필요한 Trace를 최대한 남겼습니다. 반면 오류가 발생한 상황은 환경과 관계없이 가능한 한 보존하도록 했습니다.
전환은 끝났지만, 운영은 이제 시작이었다
처음에는 GlitchTip을 Sentry로 변경하고 SDK 설정을 마치면 모니터링 환경 전환도 대부분 끝날 것이라고 생각했습니다.
하지만 실제로 데이터를 쌓기 시작하면서 데이터를 수집하는 것과 그 데이터를 이용해 서비스를 운영하는 것은 다른 문제라는 것을 알게 되었습니다.
오류는 수집되고 있었지만 서버 자체가 중단됐을 때 이를 바로 알아차릴 방법은 부족했고, Performance 데이터를 모은다고 해서 어떤 지표를 봐야 하는지나 어떤 상황에서 알림을 보내야 하는지가 자동으로 정해지는 것도 아니었습니다.
실제로 이후에는 Stage 서버가 OOM으로 중단됐지만 약 50분 동안 이를 인지하지 못한 일이 있었고, 이를 계기로 Uptime Monitor와 별도의 health endpoint를 구성하게 되었습니다.
또한 Dashboard와 Metric Alert를 만들고, Release와 실제 Deploy 시점을 연결했으며, 운영 데이터를 보면서 의미 없는 Alert와 잘못 정의된 Metric을 계속 수정했습니다.
Sentry를 연결하는 것보다 오히려 어떤 상태를 관찰하고, 언제 사람이 확인해야 하는지를 정하는 과정이 더 많은 고민을 필요로 했습니다.
이 내용은 다음 글에서 이어서 정리해보려고 합니다.