Sentry를 운영에 활용하기
KOIN에서 Uptime, Alert, Deploy를 구성한 기록
프론트엔드 모니터링을 Sentry로 옮기고 다듬기
2/ 3목록 보기
- 01GlitchTip에서 Sentry로
- 02Sentry를 운영에 활용하기
- 03Sentry에 어떤 데이터를 보낼까
Sentry를 연결한 뒤에는 이전보다 훨씬 많은 정보를 확인할 수 있게 되었습니다. 오류가 어느 Release에서 발생했는지, 사용자가 어떤 행동을 했는지, 요청 과정에서 어느 구간에 시간이 오래 걸렸는지 등을 확인할 수 있었고, 처음에는 이 정도면 모니터링 환경이 어느 정도 갖춰졌다고 생각했습니다.
하지만 실제로 서비스를 운영하면서 데이터를 수집하고 있다는 것과 문제가 발생했을 때 빠르게 알아차리고 대응할 수 있다는 것은 다른 문제라는 것을 알게 되었습니다.
서비스가 죽었을 때 언제 알 수 있을까
이 문제를 가장 크게 느꼈던 것은 Stage 서버에서 OOM이 발생했을 때였습니다.
당시 서버에서는 20시 27분 경 V8 Heap OOM이 발생했고 이후 프로세스가 반복해서 재시작되었습니다. 결국 21시 06분에는 systemd의 재시작 제한에 도달하면서 서비스가 완전히 중단됐습니다.
Aug 04 20:27:15 koin-stage: FATAL ERROR: Ineffective mark-compacts near heap limit
Allocation failed - JavaScript heap out of memory

Aug 04 20:27:17 systemd: koin-stage.service: Main process exited
Aug 04 20:27:22 systemd: Scheduled restart job, restart counter is at 1.

...

Aug 04 21:06:08 systemd: koin-stage.service: Main process exited
Aug 04 21:06:13 systemd: Start request repeated too quickly.
Aug 04 21:06:13 systemd: Failed to start koin-stage.service
하지만 문제를 바로 인지하지는 못했습니다. 최초 크래시 이후 약 50분이 지나서야 서비스 중단을 확인했고, 이후 서버 로그를 직접 살펴본 뒤에야 OOM과 반복 재시작이 원인이었다는 것을 파악할 수 있었습니다.
이 경험을 통해 Sentry에 Error Tracking을 연결해두었다고 해서 서버의 상태까지 자동으로 알 수 있는 것은 아니라는 점을 알게 되었습니다. 애플리케이션이 정상적으로 실행되고 있다면 오류 이벤트를 전송할 수 있지만, 프로세스 자체가 내려가버린 상황에서는 Sentry SDK 역시 이벤트를 전송할 수 없습니다.
결국 애플리케이션 내부에서 발생하는 오류를 관찰하는 것과, 서비스가 외부에서 정상적으로 접근 가능한지를 관찰하는 것은 별개의 문제였습니다. 그래서 서비스 자체의 가용성을 확인할 수 있도록 Sentry의 Uptime Monitor를 적용하기로 했습니다.
어떻게 감시할까
처음 생각하기에는 서비스의 메인 페이지인 /에 주기적으로 요청을 보내면 충분하다고 생각했습니다. 하지만 KOIN의 nginx에서는 일부 페이지를 캐싱하고 있었기 때문에, Next.js 프로세스가 중단되더라도 캐시가 남아 있다면 / 요청에는 정상적인 200 응답이 반환될 가능성이 있었습니다.
즉, 실제 서버 프로세스는 내려가 있는데도 모니터링에서는 정상으로 판단할 수 있는 상황이었습니다.
그래서 Next.js 프로세스의 상태만 확인할 수 있도록 /api/health 엔드포인트를 별도로 만들었습니다. 정상적인 경우에는 다음 정보를 반환하도록 구성했습니다.
- HTTP 200
- 현재 실행 환경(production, stage)
- 현재 배포된 Git SHA
- status: ok
또한 health 요청에는 nginx cache가 적용되지 않도록 했습니다. 이렇게 하면 Next.js 프로세스가 내려가거나 포트에 연결할 수 없는 상황에서 nginx가 502 또는 504를 반환하고, Uptime Monitor가 이를 직접 감지할 수 있습니다.
다만 /api/health에서 API나 데이터베이스 같은 외부 의존성까지 함께 확인하지는 않았습니다. 외부 API가 일시적으로 실패했다고 해서 Next.js 서버 자체가 중단된 것으로 판단하면 서로 다른 종류의 장애가 하나의 신호에 섞일 수 있기 때문입니다.
따라서 /api/health는 Next.js 프로세스가 살아 있는지를 확인하는 liveness 역할만 담당하도록 했습니다. 반면 실제 사용자가 서비스에 정상적으로 접근할 수 있는지는 / 등의 페이지를 대상으로 하는 별도의 End-to-End Monitor에서 확인하도록 역할을 나눴습니다.
이렇게 Production과 Stage 모두 liveness를 감시하고, 주요 사용자 흐름은 별도의 Uptime Monitor를 통해 확인하도록 구성했습니다.
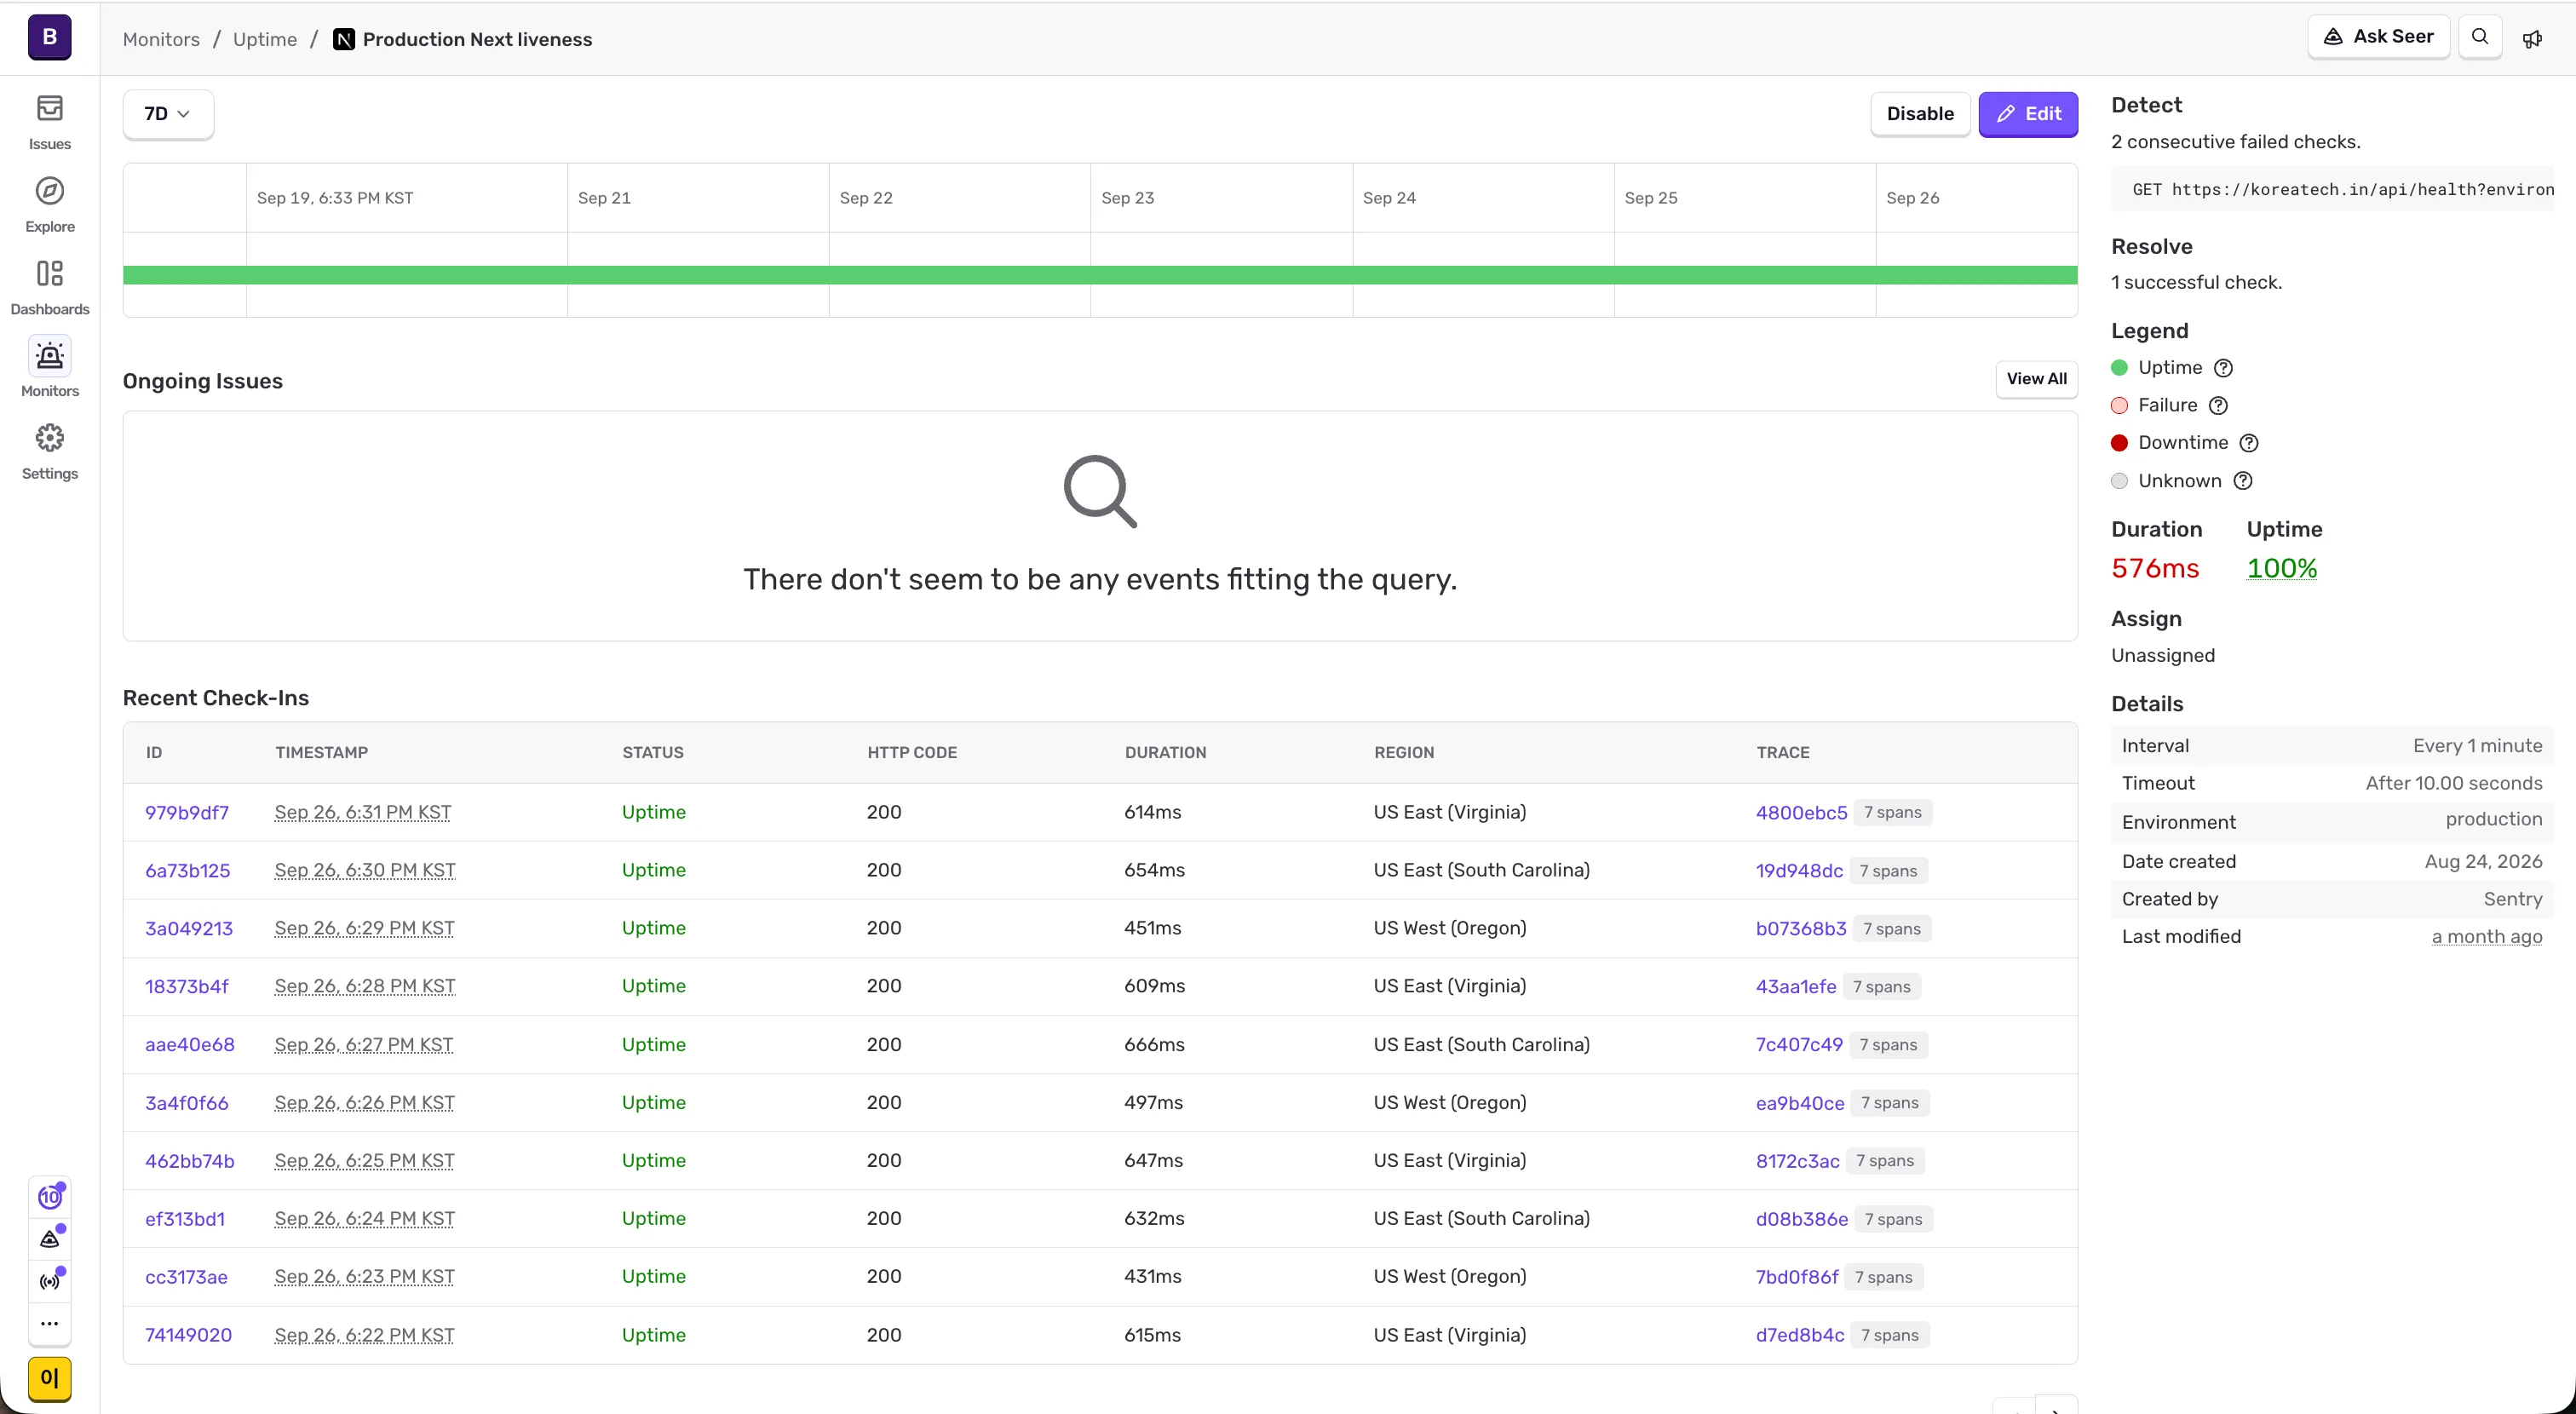
실제로 장애를 감지할 수 있을까
Monitor를 만들어두는 것만으로는 실제 장애 상황에서 제대로 동작한다고 확신하기 어려웠습니다. 그래서 Production이 아닌 Stage 환경에서 Next.js 프로세스를 직접 중단해 장애 상황을 만들어봤습니다.
프로세스가 중단되자 /api/health 요청에서 502 Bad Gateway가 발생했고, 연속 실패를 감지한 Sentry가 Downtime Issue를 생성했습니다. 설정해둔 Slack 채널에도 동일한 장애 알림이 전달되는 것을 확인할 수 있었습니다.
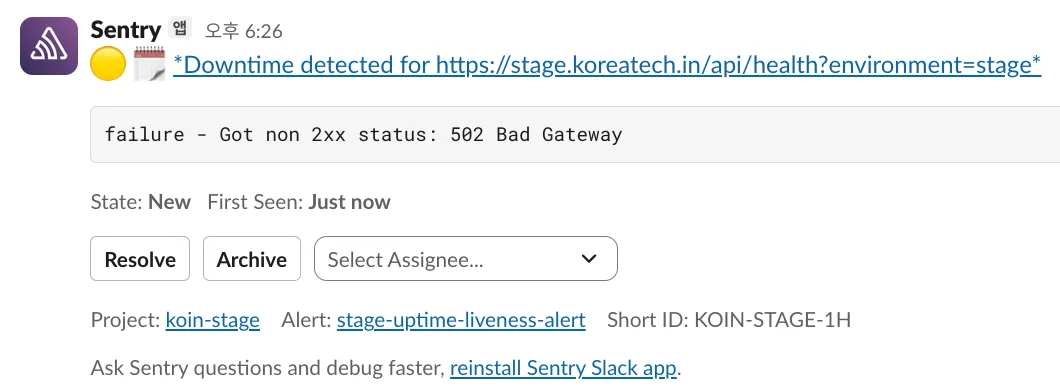
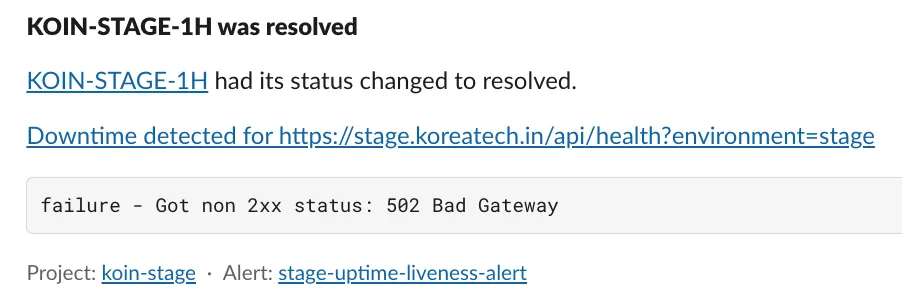
이후 Stage의 Next.js 프로세스를 다시 실행하자 health 응답이 정상 상태로 돌아왔고, Sentry에서도 기존 Downtime Issue가 resolved 상태로 변경되는 것을 확인했습니다.
다만 Uptime Monitor가 장애의 원인까지 알려주는 것은 아닙니다. 예를 들어 OOM 직전 Heap 사용량이 얼마나 높았는지, systemd가 몇 번 재시작했는지와 같은 정보는 외부 HTTP 요청만으로는 알 수 없습니다.
그래서 Uptime의 역할은 서비스가 응답하지 않는다는 사실을 빠르게 알려주는 것까지로 두었습니다. 장애를 감지한 이후 OOM이나 반복 재시작과 같은 근본 원인은 journalctl이나 서버 메트릭을 통해 확인하는 방식으로 역할을 분리했습니다.
배포와 오류를 연결하기
다음으로 보완한 것은 Release와 Deploy였습니다.
기존에도 Git SHA를 기준으로 Sentry Release를 생성하고 있었기 때문에 오류가 어떤 코드 버전에서 발생했는지는 확인할 수 있었습니다. 하지만 Release 정보만으로는 그 코드가 실제 서버에 언제 배포됐는지까지 알기 어려웠습니다.
특히 새로운 오류가 발생했을 때 최근 코드 변경과 관련이 있는지 판단하려면 단순히 Release가 존재하는 것보다 실제 배포 시점을 함께 확인할 수 있는 정보가 필요했습니다.
그래서 GitHub Actions의 배포 과정에 Sentry Deploy 등록을 추가했습니다.
- name: Record Sentry Deploy
  run: |
    yarn sentry-cli releases deploys "$SENTRY_RELEASE" new \
      --env "$SENTRY_ENVIRONMENT" \
      --name "github-${GITHUB_RUN_ID}-${GITHUB_RUN_ATTEMPT}"
이때 Deploy를 등록하는 시점도 중요했습니다. 빌드가 성공했다고 해서 실제 서버에 새로운 버전이 정상적으로 올라갔다고 볼 수는 없기 때문에, 원격 서버 배포가 끝난 뒤 /api/health를 통해 새로운 Release가 정상적으로 실행되는 것을 확인한 경우에만 Deploy를 생성하도록 했습니다.
health 응답에 현재 Git SHA를 포함시킨 것도 같은 이유였습니다. 단순히 서버가 200을 반환하는지를 보는 데서 끝나는 것이 아니라, 현재 실행되고 있는 서버가 방금 배포한 Release가 맞는지까지 확인할 수 있도록 했습니다.
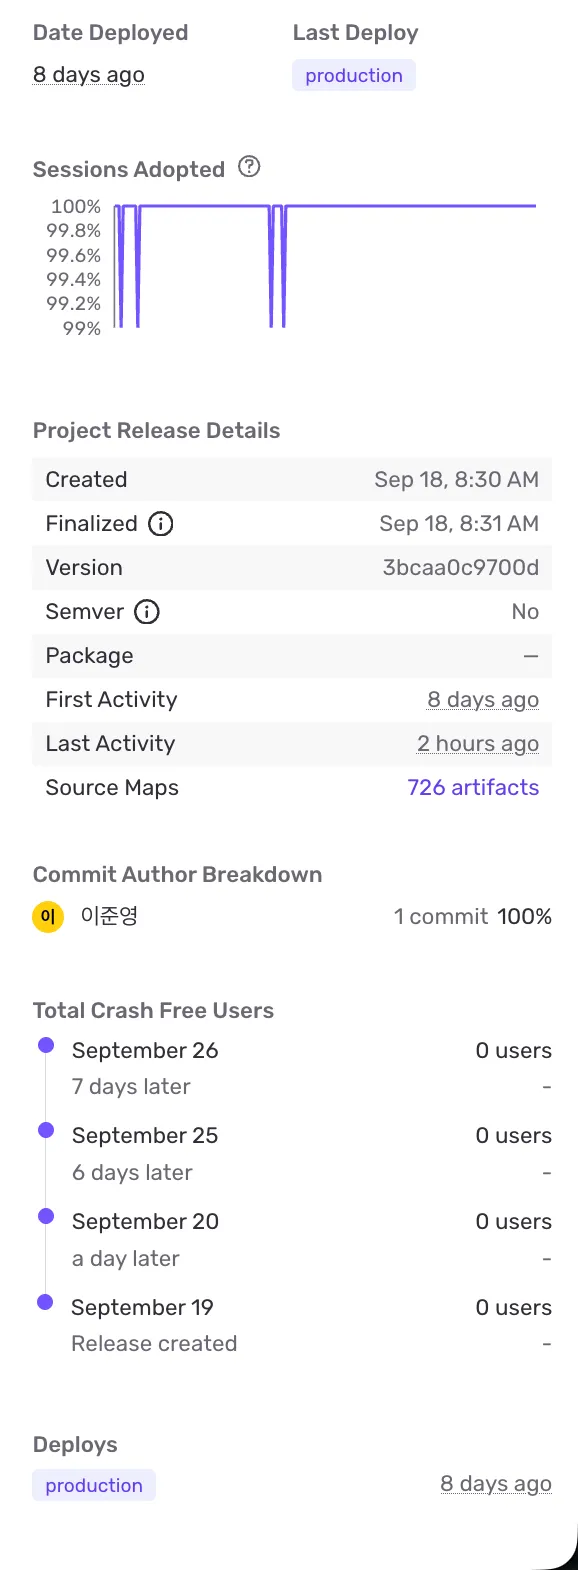
이렇게 Release와 Deploy를 연결한 뒤에는 새로운 문제가 발생했을 때 최근 배포 직후부터 시작된 문제인지 확인하기가 훨씬 쉬워졌습니다.
문제를 확인하는 순서도 자연스럽게 정리할 수 있었습니다.
최근 Release와 Deploy 확인 → 영향받은 사용자와 이벤트 확인 → Session Replay 확인 → Trace 확인
각각의 기능을 따로 사용하는 것보다 하나의 흐름 안에서 연결해서 보는 것이 실제 문제를 분석할 때 더 유용했습니다.
어떤 지표를 감시해야 할까
Uptime을 통해 서비스가 살아 있는지는 확인할 수 있게 되었지만, 서비스가 정상적으로 응답하고 있다고 해서 내부 상태까지 모두 정상인 것은 아닙니다.
응답은 하고 있지만 오류가 평소보다 많이 발생할 수도 있고, 특정 페이지의 응답 시간이 점점 느려지고 있을 수도 있습니다. 이런 변화는 서비스가 완전히 중단되기 전에 나타나는 신호일 수 있기 때문에, Sentry에 쌓이고 있던 데이터를 실제 운영 지표로 활용해보기로 했습니다.
먼저 최근 14일의 Production 데이터를 확인하면서 어떤 변화가 있었는지를 살펴봤습니다.
전체 요청의 p95는 이전 7일의 약 277ms에서 이후 7일 약 590ms로 증가했고, 트래픽은 오히려 줄었지만 internal_error는 377건에서 453건으로 늘어났습니다. 특히 게시글 상세 요청인 GET /articles/[id]는 p95가 약 159ms에서 691ms까지 증가했고 실제 500 오류도 함께 발생하고 있었습니다.
Next Image 역시 느린 Trace를 확인했을 때 전체 4.5초 정도의 처리 시간 중 upstream 이미지 요청에 약 4.1초가 사용되는 경우가 있었습니다.
이런 데이터를 바탕으로 다음과 같은 질문에 답할 수 있도록 Dashboard와 Metric Monitor를 구성했습니다.
- 전체적인 오류가 평소보다 증가하고 있는가
- 오류가 영향을 주는 사용자 범위가 넓어지고 있는가
- 전체 요청의 tail latency가 악화되고 있는가
- 특정 기능에서만 성능 문제가 나타나고 있는가
- 실제 사용자가 체감하는 Web Vitals가 나빠지고 있는가
단순히 측정 가능한 값을 모두 올리는 것이 아니라, 현재 서비스 상태가 평소와 달라졌는지를 판단하는 데 도움이 되는 지표를 우선했습니다.
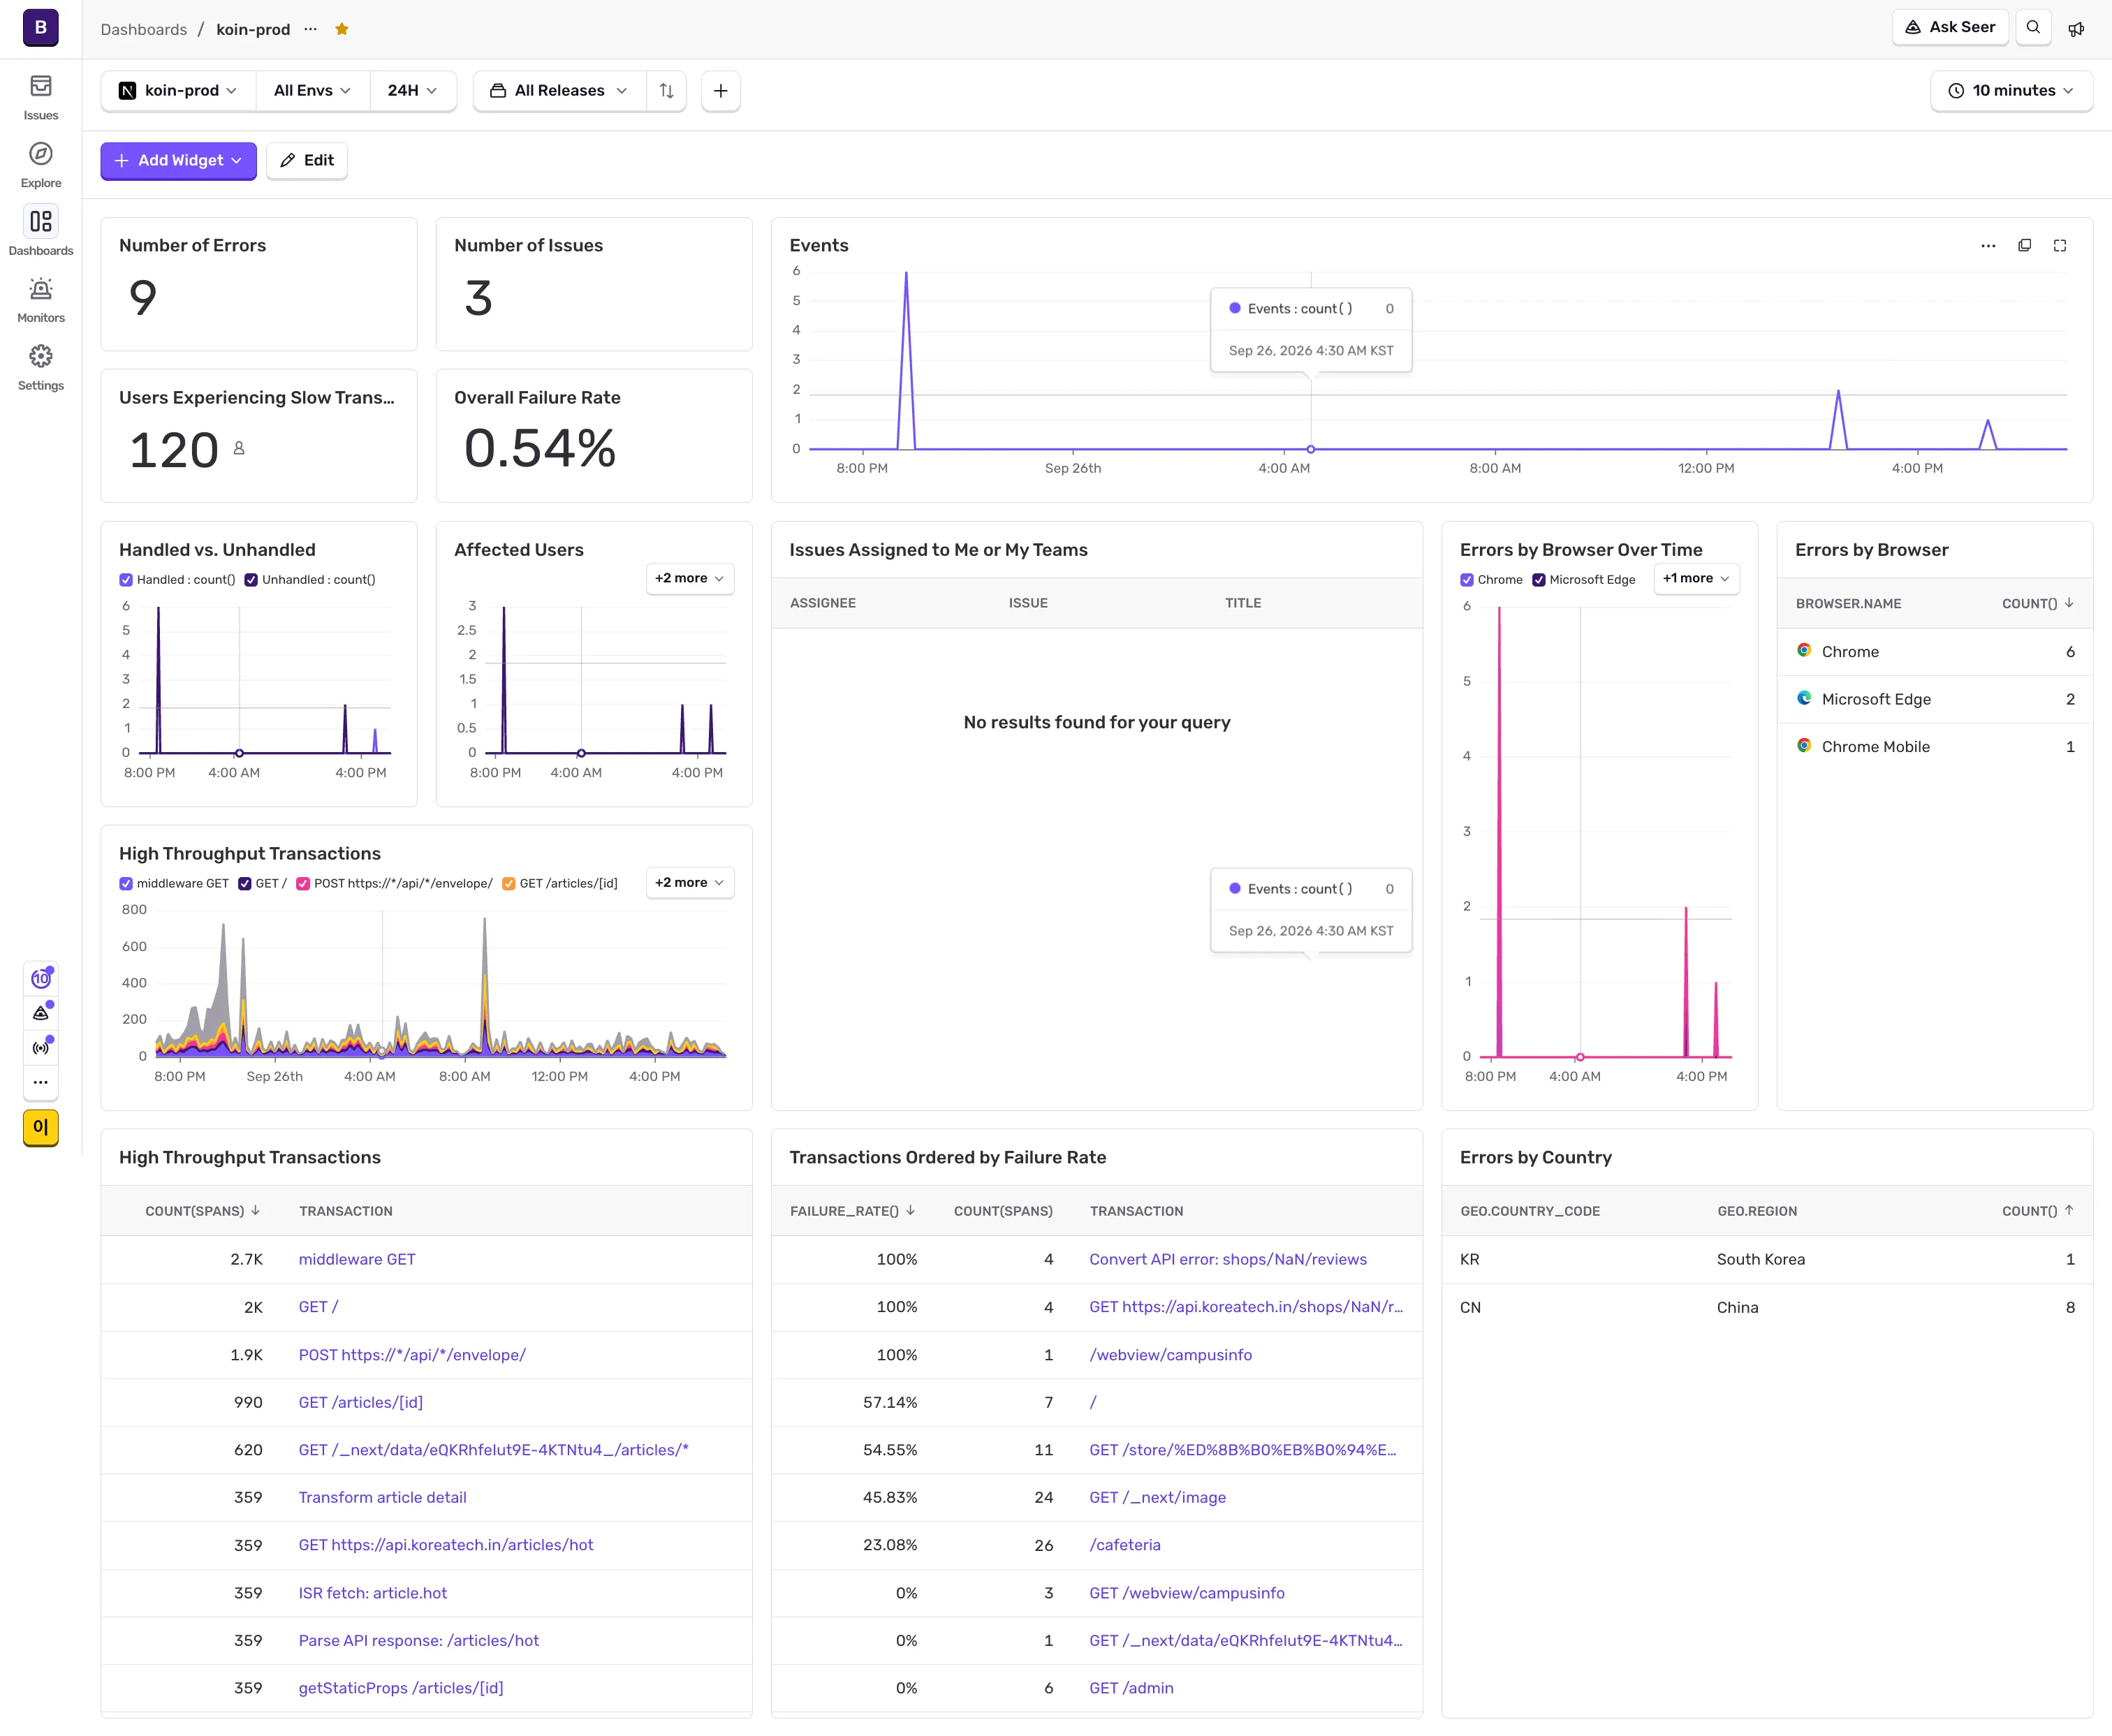
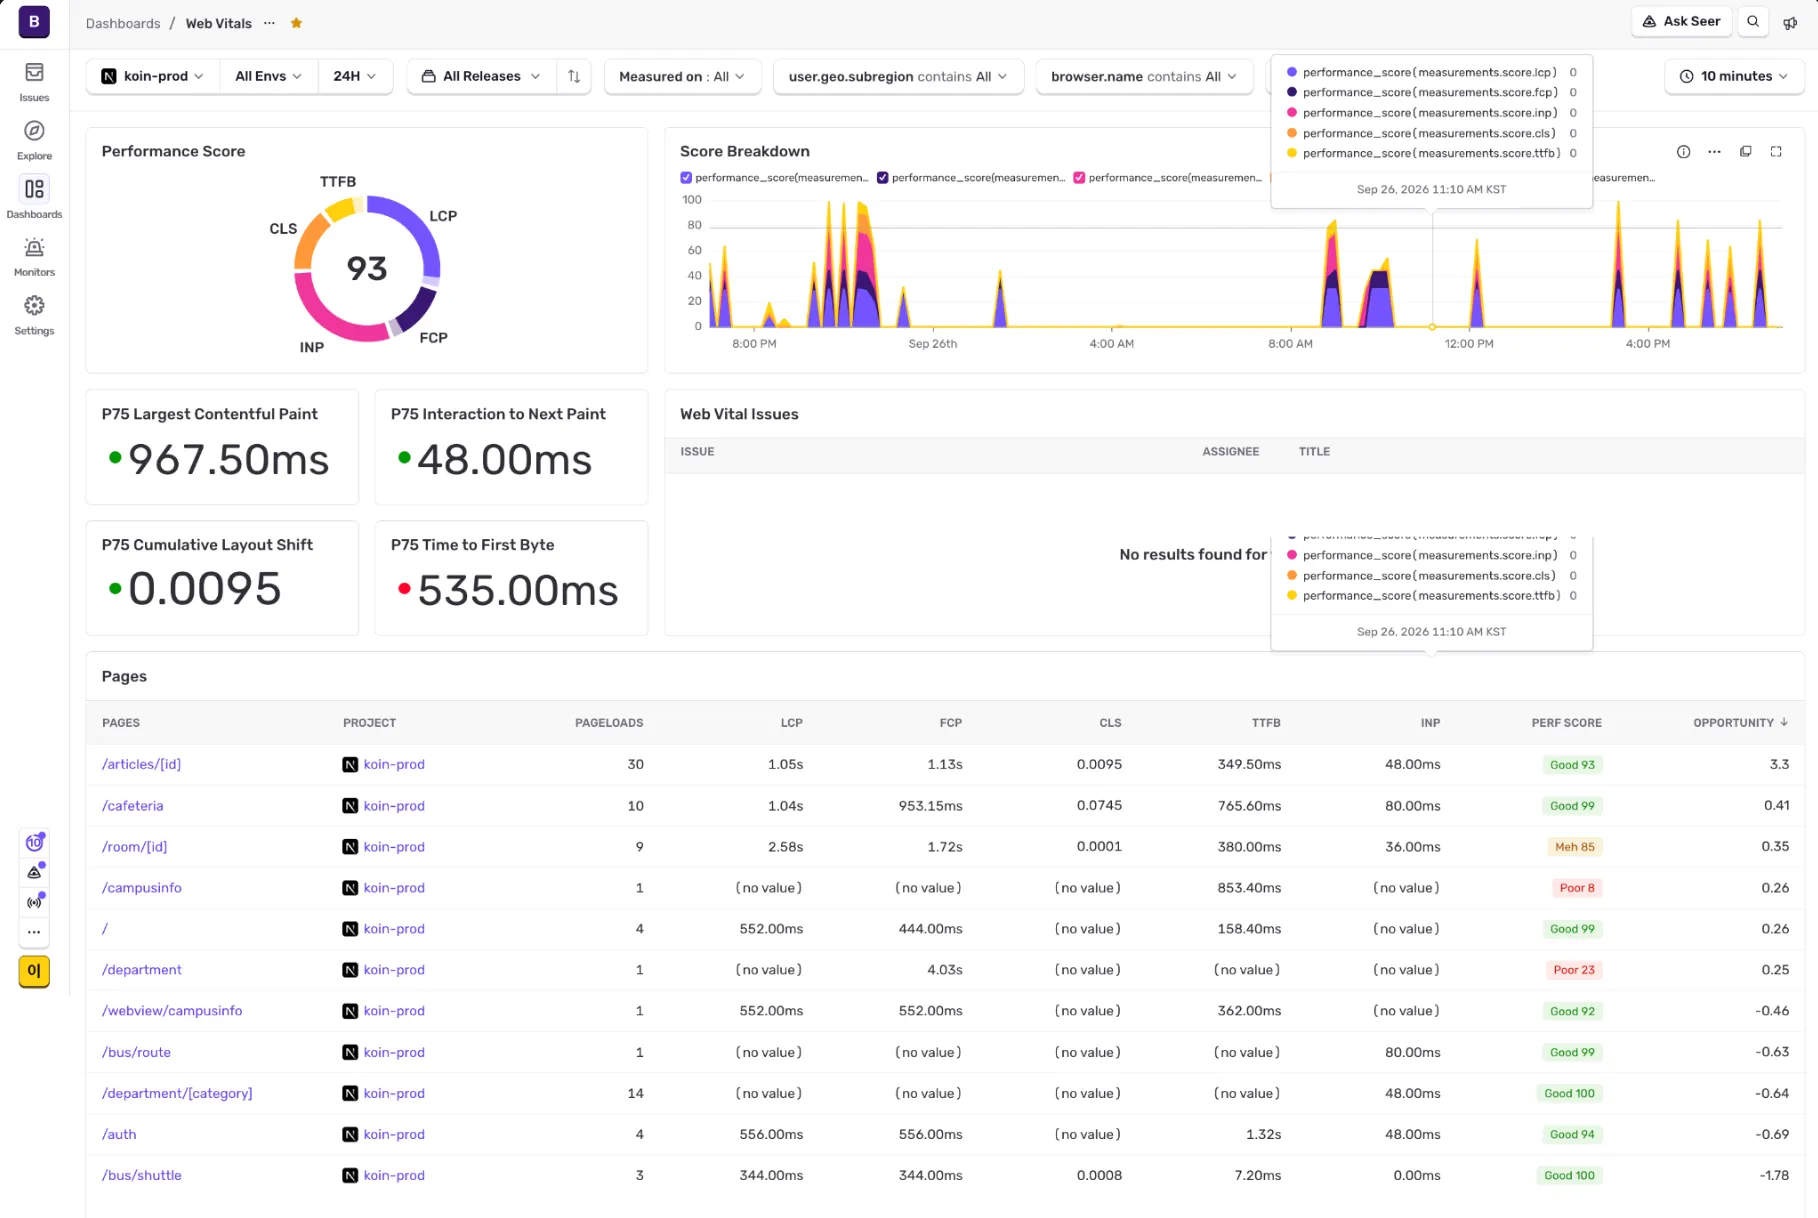
프론트엔드 관점의 사용자 체감 성능은 서버 Transaction과 별도로 볼 필요가 있었기 때문에 LCP, INP, CLS, TTFB 등의 Web Vitals도 별도의 Dashboard에서 확인하도록 했습니다.
초기에는 다음 항목들을 Metric Monitor 후보로 두었습니다.
| Monitor | 확인하려던 문제 |
|---|---|
| Internal Error | 요청량과 관계없이 내부 오류가 증가하는지 |
| Overall p95 | 서비스 전체의 tail latency가 악화되는지 |
| Article Detail p95 | 실제로 성능 악화와 500 오류가 관찰된 게시글 상세 요청 |
| Next Image p95 | 느린 Trace에서 확인된 이미지 upstream 지연 |
처음 임계값은 당시 관측된 값을 기준으로 잡고, 운영하면서 실제 알림 빈도를 확인한 뒤 다시 조정하는 방향으로 시작했습니다.
하지만 실제로 Monitor를 운영해보니, 문제가 있어 보이는 지표라고 해서 모두 Alert에 적합한 것은 아니었습니다.
가장 먼저 문제가 된 것은 표본의 수였습니다.
예를 들어 Next Image 관련 latency는 초기 조사에서는 느린 Trace가 확인되어 별도의 Monitor를 만들었지만, 이후 데이터를 다시 확인했을 때 7일과 30일 범위 모두 표본이 10건밖에 없었습니다.
이 정도 표본으로 p95를 계산하면 몇 건의 요청만으로 값이 크게 달라질 수 있기 때문에 이를 기준으로 Alert를 발생시키는 것은 의미가 크지 않다고 판단했습니다. 결국 Next Image Metric Monitor는 삭제하고 대시보드와 원본 Span 데이터만 유지했습니다.
반대로 Internal Error는 충분한 데이터가 쌓이고 있었기 때문에 Monitor를 제거하기보다 최근 30일 분포를 기준으로 임계값을 다시 조정했습니다. 정상적인 변동에도 계속 알림이 발생하지 않도록, 평소 수준과 실제 이상 상황을 구분할 수 있는 값을 다시 잡았습니다.
결과적으로 Monitor를 구성할 때 중요한 것은 많은 지표에 Alert를 붙이는 것이 아니라 해당 지표에 충분한 데이터가 있고 정상 상태와 이상 상태를 구분할 수 있는가였습니다.
p95가 높으면 서버가 느린걸까
Article Detail p95 Monitor는 임의로 만든 지표가 아니었습니다.
앞서 Production 데이터를 확인했을 때 게시글 상세 요청의 p95가 약 159ms에서 691ms까지 증가했고 실제 500 오류도 함께 발생하고 있었기 때문에, 별도의 Metric으로 추적하기로 했습니다.
초기에는 당시 관측값보다 조금 높은 800ms를 Warning, 1.5초를 Critical 기준으로 설정했습니다. 그리고 실제 운영을 시작한 뒤 얼마 지나지 않아 이 Monitor에서 Critical Alert가 발생했습니다.
당시 10분 구간의 p95는 약 3.5초까지 올라갔고 Critical 기준인 1.5초를 크게 넘었습니다. 숫자만 보면 게시글 상세 요청의 서버 처리가 갑자기 느려진 것처럼 보였습니다.
하지만 Trace 데이터를 조금 더 자세히 확인해보니 상황이 달랐습니다.
기존 Monitor에서는 다음과 같이 article_detail이라는 기준만 사용하고 있었습니다.
koin.transaction_key:article_detail문제는 이 조건에 서버에서 처리되는 http.server뿐 아니라 브라우저의 pageload도 함께 포함되고 있었다는 점이었습니다.
30일 범위에서 두 Span을 분리해 비교해보니 차이가 더 명확했습니다.
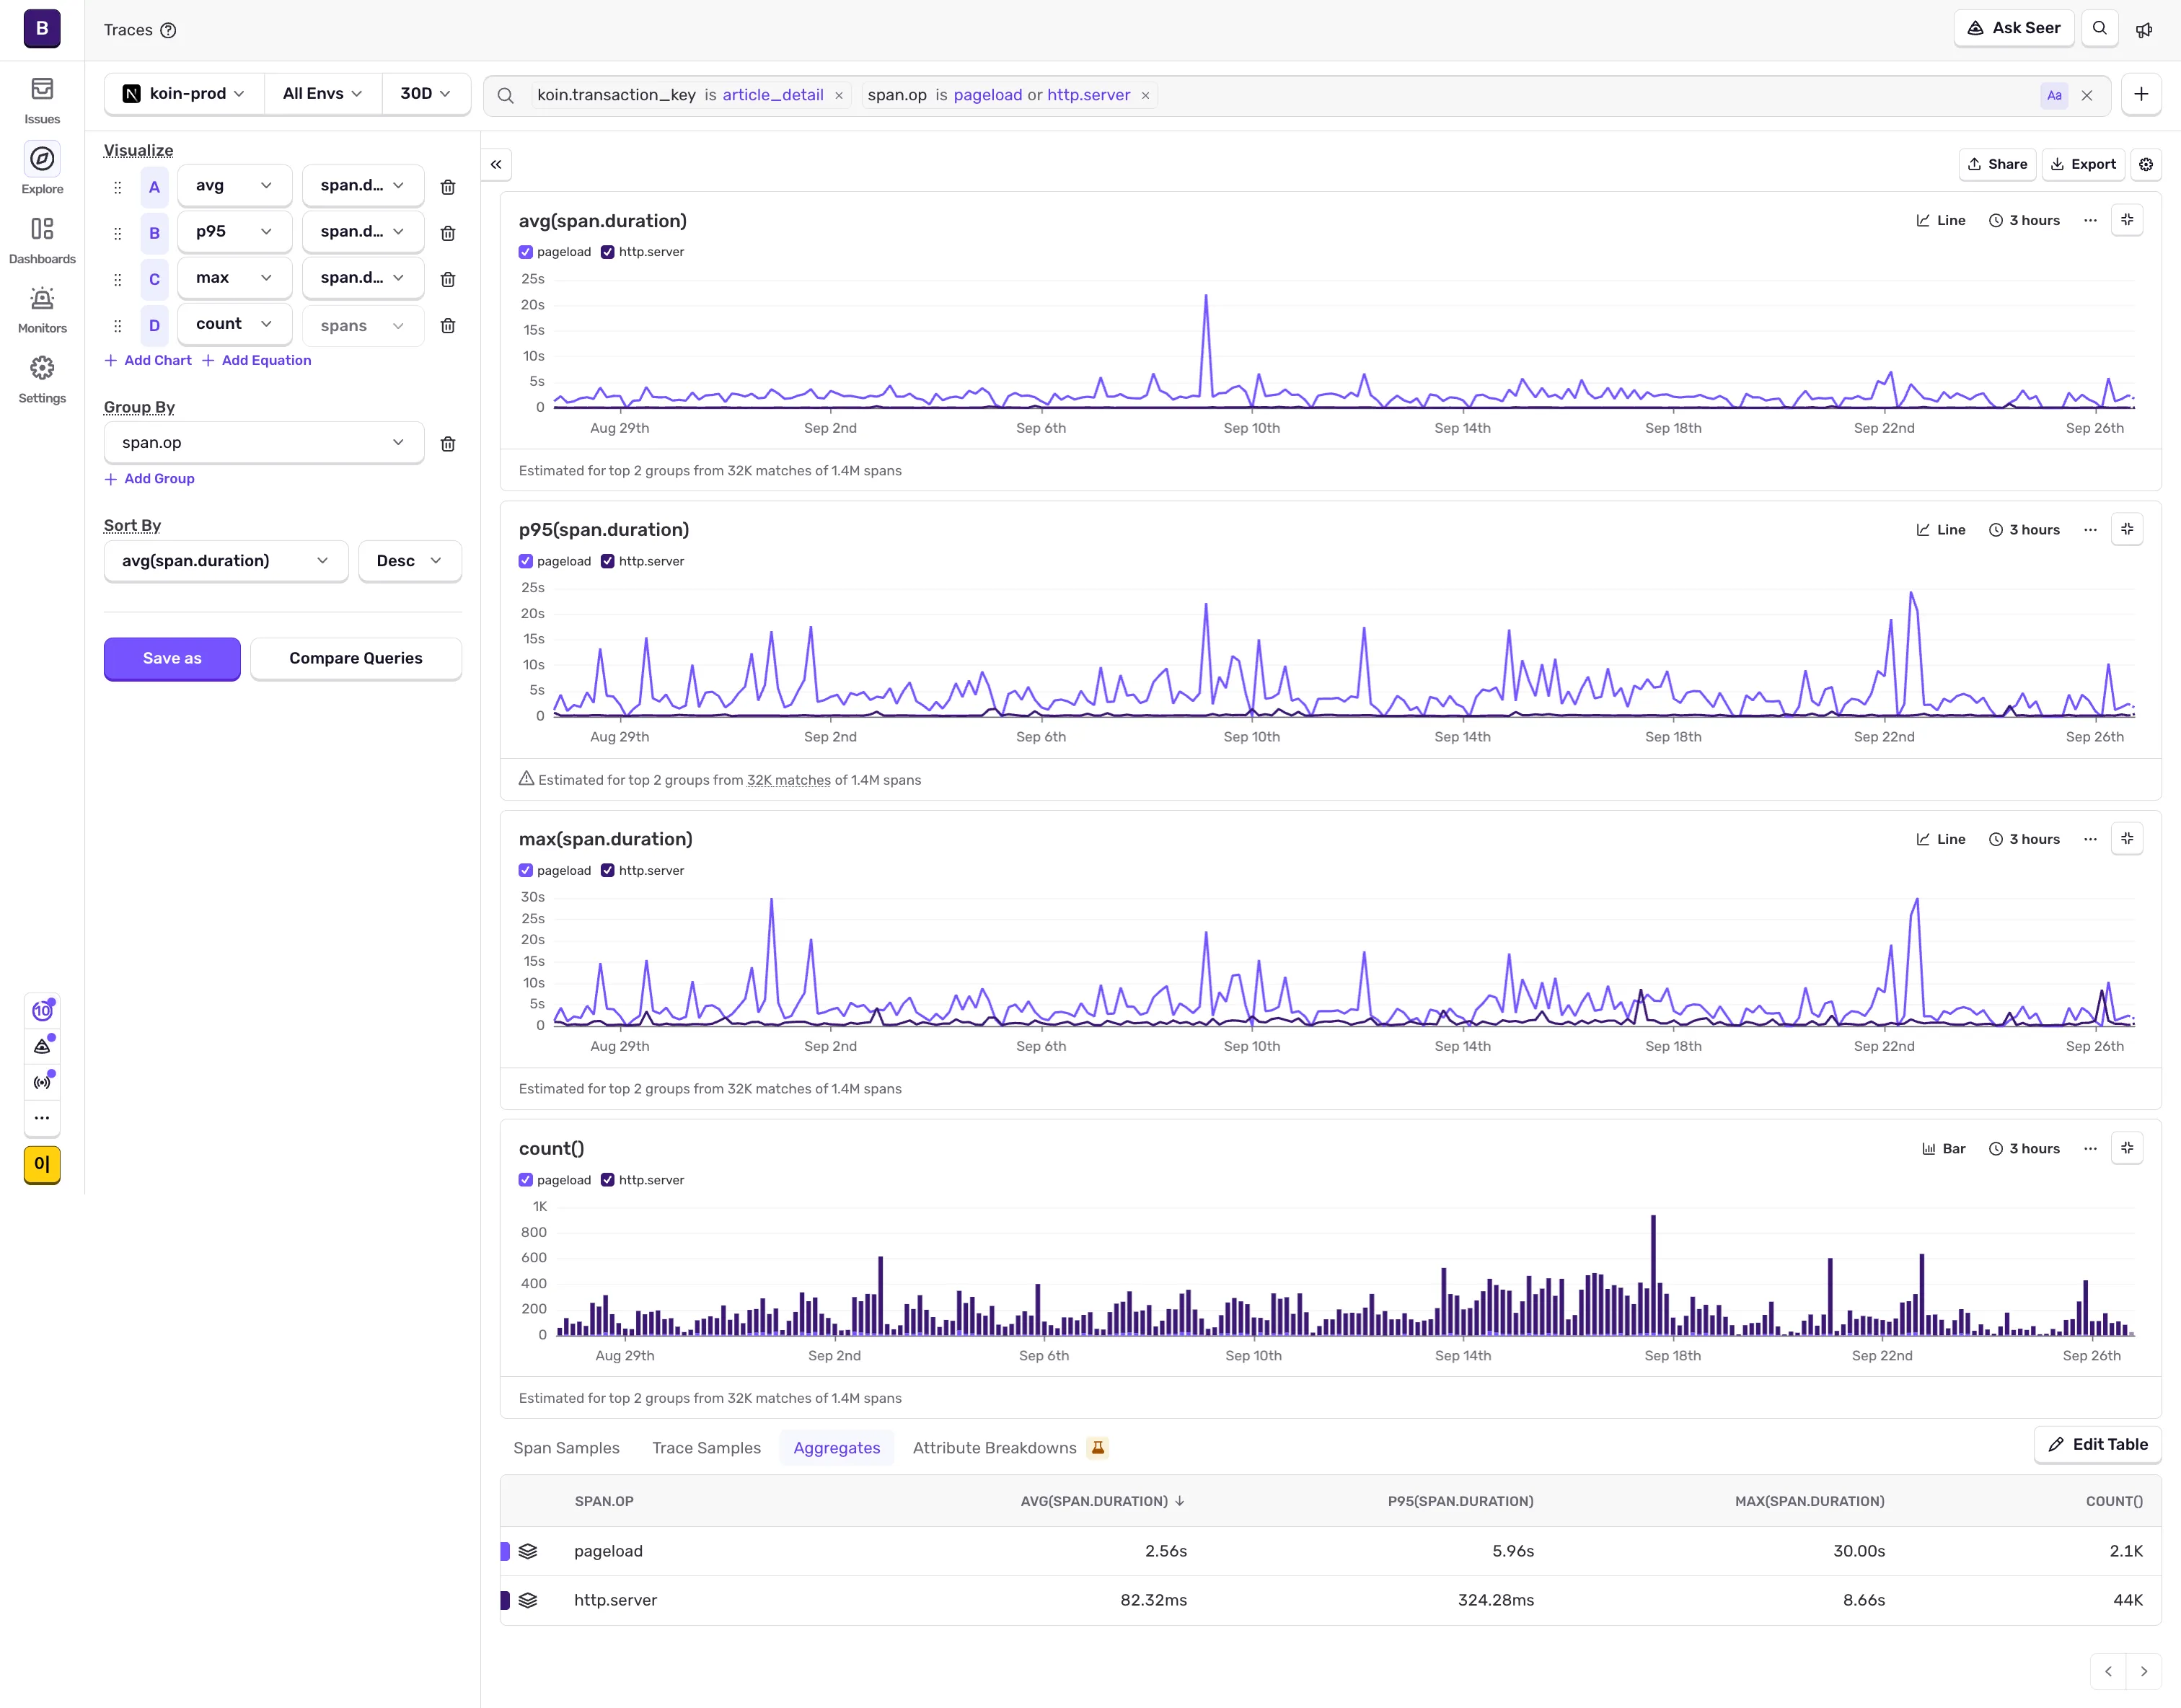
pageload의 p95는 약 5.96초였지만 http.server의 p95는 약 324ms 수준이었습니다.
실제 Alert가 발생했던 10분 구간에서도 약 6.1초가 걸린 클라이언트 pageload 한 건이 적은 표본 안에서 p95를 크게 끌어올리고 있었습니다. 반면 같은 구간의 http.server Span은 평균 약 111ms, 최대 약 320ms 수준으로 서버 처리 자체에는 큰 문제가 없었습니다.
즉 서버가 느려진 것이 아니라 서로 다른 성격의 데이터를 하나의 Metric으로 집계하고 있었던 것이 문제였습니다.
Article Detail Monitor의 목적은 서버 처리 지연을 감지하는 것이었기 때문에 다음과 같이 http.server Span으로 범위를 좁혔습니다.
koin.transaction_key:article_detail span.op:http.server같은 문제 구간을 다시 조회했을 때 p95는 약 3.5초에서 320ms 수준으로 내려갔습니다.
결국 임계값 자체가 잘못된 것이 아니라, 그 임계값에 넣고 있던 데이터의 의미가 잘못 정의되어 있었던 것입니다.
이 경험을 통해 Monitor를 구성할 때 적절한 임계값을 정하는 것만큼이나 내가 보고 있는 숫자가 실제로 무엇을 의미하는지 정확하게 정의하는 것이 중요하다는 것을 알게 되었습니다.
알림이 많으면 더 잘 알아차릴 수 있을까
Monitor를 만든 목적은 Dashboard를 계속 보고 있지 않아도 의미 있는 이상 상태가 발생했을 때 빠르게 알아차리기 위해서였습니다.
새로운 애플리케이션 Error와 Regression은 기존 Issue Alert를 통해 전달하고, 성능이나 오류율과 같은 Metric은 설정한 임계값을 넘었을 때 Slack으로 알려주도록 구성했습니다. Uptime 역시 서비스가 응답하지 않을 경우 별도의 Alert를 통해 전달하도록 했습니다.
처음 의도는 Error, Metric, Uptime을 각각의 성격에 맞는 경로로 알리는 것이었습니다.
하지만 실제로 운영을 시작하자 Slack으로 같은 사건에 대한 알림이 두세 개씩 들어오는 문제가 생겼습니다.
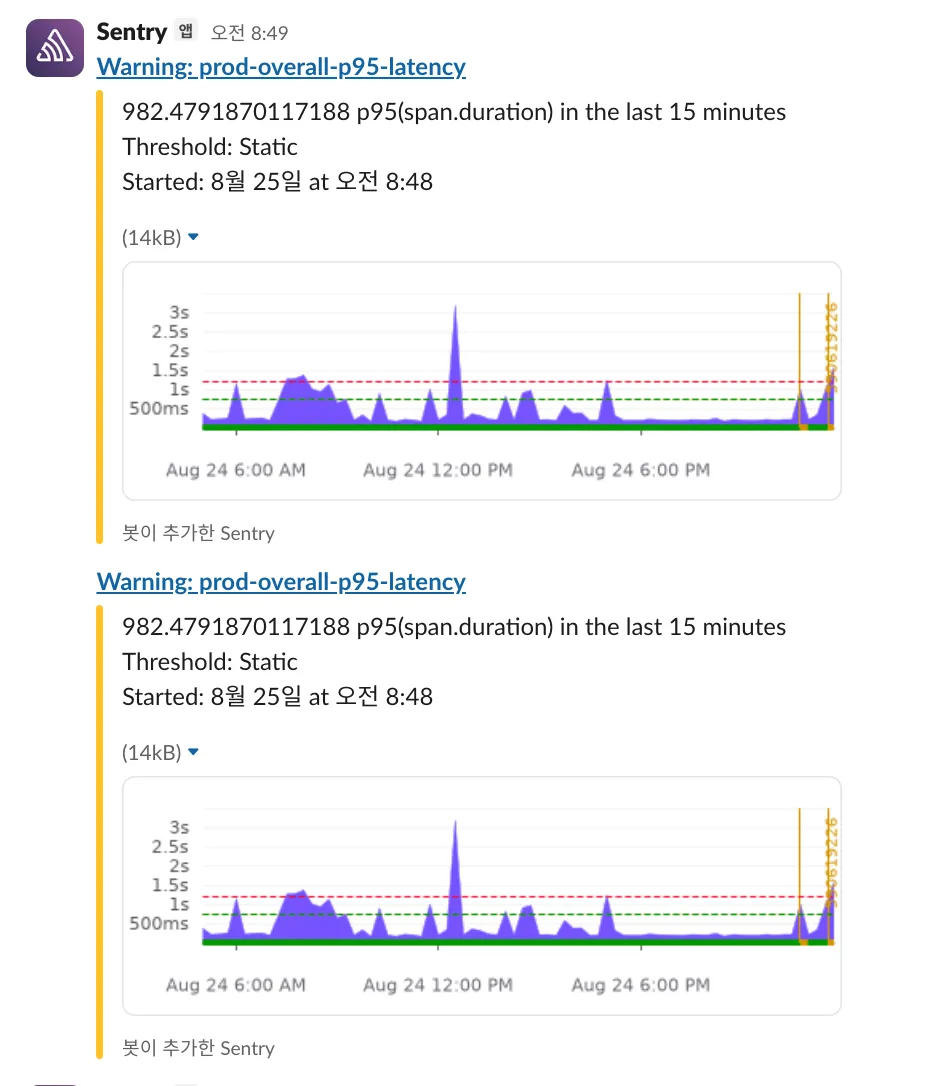
확인해보니 기존에 사용하던 프로젝트 단위 Issue Alert와 새로 만든 Alert의 조건이 겹치고 있었고, 여기에 일부 Monitor에 연결된 Slack Action까지 함께 실행되면서 하나의 사건이 여러 경로를 통해 전달되고 있었습니다.
결국 하나의 Metric Event가 발생했을 뿐인데도 Slack에서는 서로 다른 Alert가 같은 내용을 반복해서 전달하는 상황이 생겼습니다.
처음에는 Alert가 많을수록 문제를 놓칠 가능성이 줄어들 것이라고 생각할 수 있지만 실제 운영에서는 오히려 반대였습니다. 같은 내용의 알림이 반복되면서 실제로 확인해야 할 알림을 구분하기 어려워졌습니다.
그래서 Alert의 역할을 다시 나누고 Slack으로 전달되는 경로를 단순화했습니다.
| 상황 | Slack 알림 |
|---|---|
| 새로운 Error / Regression | 전송 |
| Metric Warning | 전송하지 않음 |
| Metric Critical | 전송 |
| Metric Recovery | 전송하지 않음 |
| Uptime 장애 | 전송 |
일반적인 애플리케이션 Error는 새로운 Issue가 발생하거나 기존 문제가 다시 발생했을 때만 알리도록 했고, Metric은 Warning 단계에서는 Sentry에만 기록하고 Critical 수준에 도달했을 때 Slack으로 전달하도록 했습니다.
Uptime은 서비스 접근 불가라는 성격이 분명했기 때문에 각 Uptime Monitor의 전용 알림 경로를 유지했습니다.
Recovery 알림도 처음에는 Slack으로 함께 전달했습니다. 하지만 Metric 값이 임계값 주변에서 오르내리면서 Critical과 Recovery가 반복됐고, 실제로 한 번의 Critical 이후 Recovery 메시지가 여러 번 발생하는 문제가 있었습니다.
그래서 Metric Recovery는 Sentry 내부 기록은 유지하되 Slack으로는 전달하지 않도록 변경했습니다.
또한 전체 Alert와 Workflow를 다시 확인하면서 더 이상 동작하지 않는 Monitor 전용 Workflow와 기존 Alert와 역할이 완전히 겹치는 legacy 규칙도 함께 제거했습니다.
Alert는 발생한 모든 변화를 알려주는 것이 아니라, 지금 사람이 확인해야 하는 상태를 알려주기 위한 것이었습니다.
데이터를 모으는 것보다 중요한 것
처음 Sentry를 도입했을 때는 Error, Trace, Replay와 같은 데이터를 얼마나 많이 확보할 수 있는지에 더 관심이 있었습니다.
하지만 실제 운영 환경을 구성하면서 생각이 조금 달라졌습니다.
서버가 중단된 사실을 빠르게 알 수 없다면 많은 Error Event를 가지고 있어도 부족했고, 표본이 거의 없는 p95는 의미 있는 지표가 되기 어려웠습니다. 같은 article_detail이라는 이름 아래 서로 다른 Span을 섞으면 정상적인 서버를 장애처럼 보이게 만들 수도 있었고, 모든 상태 변화를 Slack으로 전달하면 정작 중요한 알림을 놓칠 가능성도 있었습니다.
결국 Observability를 구성하면서 중요했던 것은 단순히 데이터를 많이 모으는 것이 아니라 현재 서비스의 상태를 판단할 수 있는 신뢰할 만한 신호를 만드는 것이었습니다.
Uptime은 서비스가 살아 있는지를 확인하고, Release와 Deploy는 발생한 문제를 코드 변경과 연결하며, Metric은 평소와 다른 상태가 나타났는지를 확인하도록 역할을 나눴습니다.
실제 운영 데이터를 보면서 표본이 부족한 Monitor는 제거하고, 평가 구간과 임계값을 조정했으며, 잘못 정의된 쿼리는 다시 좁혔습니다. Alert 역시 실제 Slack 알림을 확인하면서 중복되는 경로를 계속 줄여나갔습니다.
이 과정을 거치면서 Sentry는 단순히 에러를 모아두는 도구에서 실제 서비스 운영을 돕는 도구로 조금씩 바뀌었습니다.
하지만 SaaS 형태의 Sentry를 적극적으로 활용하면서 또 다른 고민도 생겼습니다.
Session Replay, Request Context, Logs처럼 더 많은 데이터를 수집할수록 어떤 정보까지 외부 서비스로 보내도 되는가를 생각해야 했습니다.
다음 글에서는 실제 Sentry 데이터에서 JWT가 노출된 사례를 시작으로 Session Replay 마스킹, dataCollection, Data Scrubbing 등을 적용하며 수집 범위를 조정한 과정을 정리해보려고 합니다.