Sentry에 어떤 데이터를 보낼까
Sentry로 보내는 개인정보와 민감정보의 범위를 정리한 기록
프론트엔드 모니터링을 Sentry로 옮기고 다듬기
3/ 3목록 보기
- 01GlitchTip에서 Sentry로
- 02Sentry를 운영에 활용하기
- 03Sentry에 어떤 데이터를 보낼까
앞선 글에서는 Sentry를 Error Tracking 도구에서 실제 서비스 운영에 활용할 수 있도록 Uptime, Metric Alert, Release와 Deploy 등을 구성한 과정을 정리했습니다.
이렇게 Sentry에서 확인할 수 있는 데이터를 늘려가면서 문제를 조사하기는 훨씬 편해졌습니다. 하지만 Self-hosted GlitchTip을 사용할 때와는 다른 고민도 생겼습니다.
GlitchTip은 직접 운영하는 서버에 데이터를 저장했지만, Sentry SaaS에서는 Error Context, Request, Logs, Session Replay와 같은 정보가 외부 서비스로 전송됩니다.
그래서 Sentry를 적극적으로 활용하는 만큼 어떤 데이터를 보내고 있는지, 그중 실제로 필요한 데이터가 무엇인지 다시 확인할 필요가 있었습니다.
실제 로그에 JWT가 남아 있었다
하이드레이션 오류를 조사하기 위해 Sentry Logs를 살펴보던 중, Production API의 인증 실패 응답에 포함된 JWT가 원문 그대로 기록된 것을 발견했습니다.
이를 계기로 로그에 어떤 값이 포함되고 있는지 다시 확인했고, Sentry로 전송하기 전에 민감한 값을 걸러낼 필요가 있다고 판단했습니다.
그래서 JWT 형태의 문자열을 찾아 문자열뿐 아니라 배열과 객체 내부까지 순회하면서 JWT 형태의 값을 [REDACTED_JWT]로 치환하도록 했습니다.
const JWT_PATTERN = /eyJ[A-Za-z0-9_-]{8,}\.[A-Za-z0-9_-]{8,}\.[A-Za-z0-9_-]+/g;

export function maskSensitive<T>(value: T): T {
  if (typeof value === 'string') {
    return value.replace(JWT_PATTERN, '[REDACTED_JWT]') as T;
  }

  if (Array.isArray(value)) {
    return value.map(maskSensitive) as T;
  }

  if (value != null && typeof value === 'object') {
    return Object.fromEntries(
      Object.entries(value).map(([key, entry]) => [key, maskSensitive(entry)]),
    ) as T;
  }

  return value;
}
그리고 beforeSendLog에서 해당 처리를 거치도록 했습니다.
beforeSendLog(log) {
  if (log.level === 'debug') return null;

  return maskSensitive(log);
}
이렇게 하면 JWT가 Sentry에 저장된 뒤 가리는 것이 아니라, Sentry로 전송하기 전에 제거할 수 있습니다.
Sentry의 Data Scrubbing도 민감정보를 제거할 수 있지만, Sentry에 데이터가 도착한 이후 적용되는 기능입니다. 전송 자체가 필요 없는 값은 SDK 단계에서 먼저 제거하도록 했습니다.
Session Replay에는 무엇이 보일까
다음으로 확인한 것은 Session Replay였습니다.
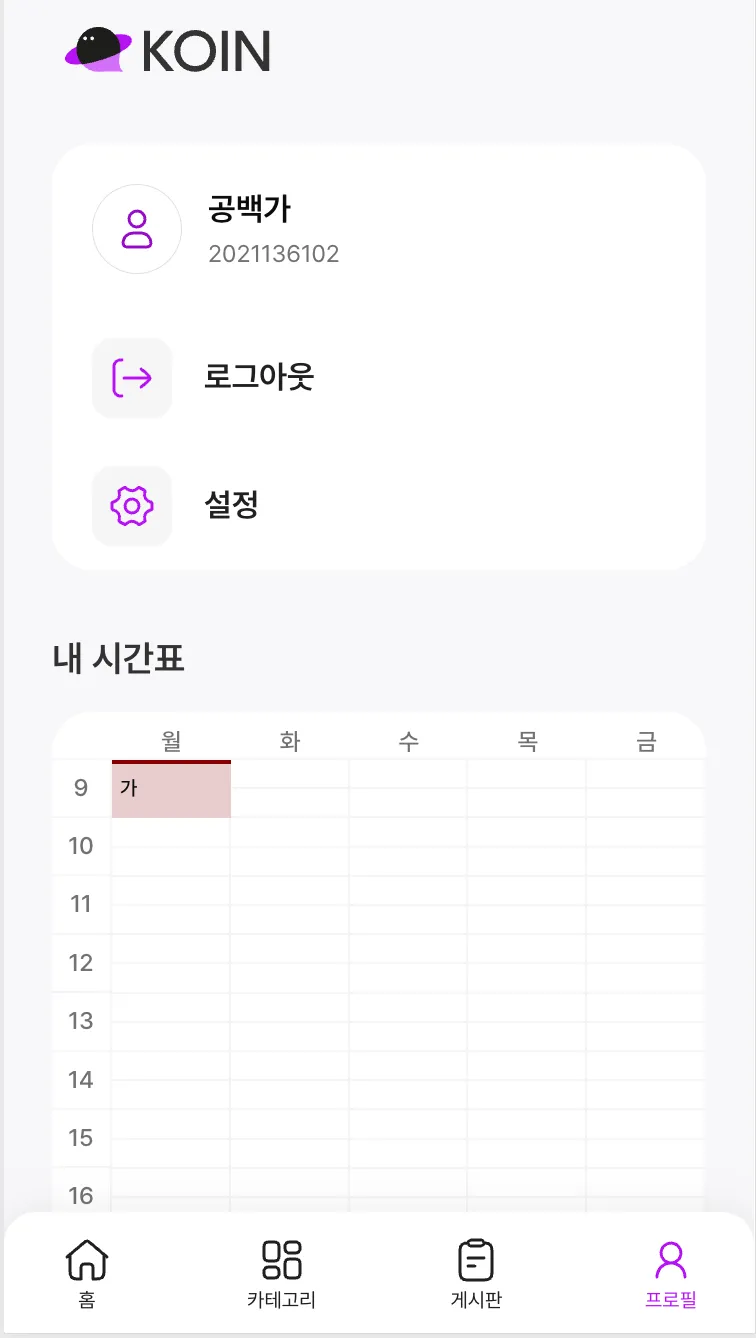
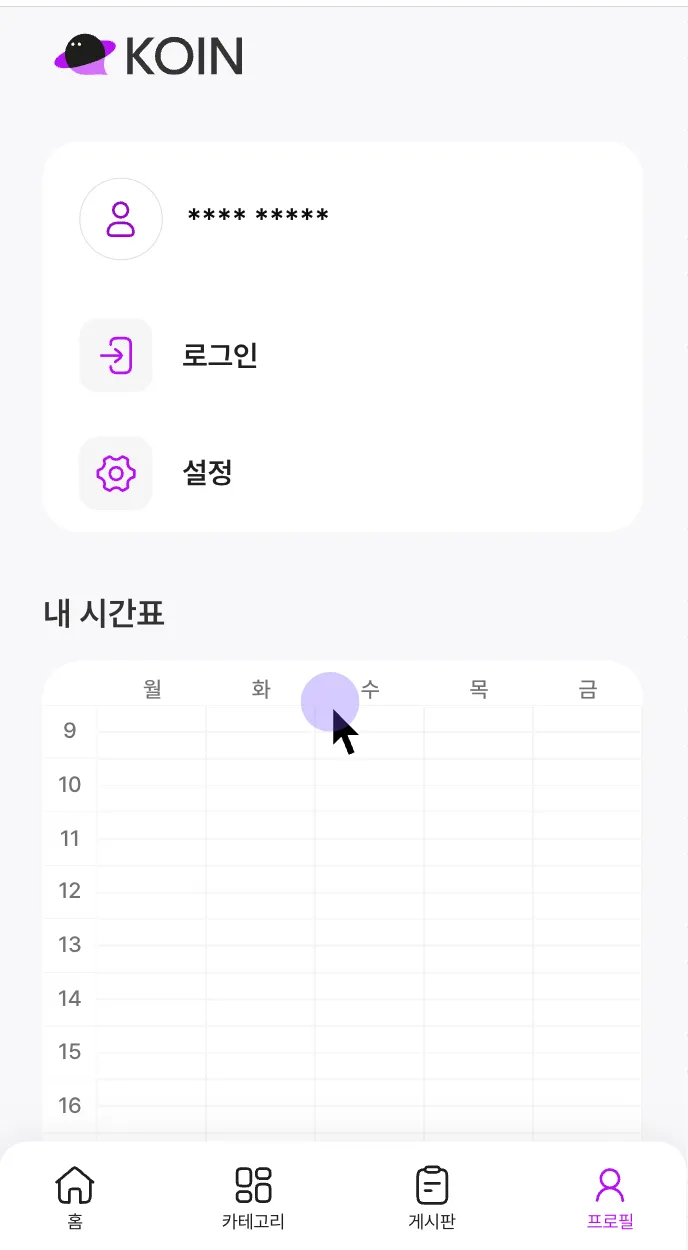
Replay는 문제가 발생하기 전에 사용자가 어떤 화면에서 어떤 행동을 했는지를 확인할 수 있어 실제 오류를 분석할 때 유용했지만 화면을 기록하는 기능인 만큼 개인정보가 함께 노출될 가능성도 있었습니다.
모든 텍스트와 입력값을 일괄적으로 가릴 수도 있었지만, 그렇게 하면 오류가 발생한 화면의 상태까지 확인하기 어려워집니다.
그래서 전체 화면을 가리기보다 개인정보가 표시되는 부분만 선택적으로 마스킹하기로 했습니다.
로그인, 회원가입, 프로필, 정보 수정, 팀원 모집 화면 등을 확인하면서 다음 정보가 표시되는 요소에 sentry-mask를 적용했습니다.
- 실명
- 전화번호
- 학번
- 로그인 아이디
예를 들어 일반적인 입력 필드는 다음과 같은 식으로 처리할 수 있습니다.
<input className="sentry-mask" value={studentNumber} />이렇게 하면 화면 구조나 사용자 행동 흐름은 그대로 확인하면서 개인정보가 표시되는 영역만 가릴 수 있습니다.
비밀번호 보기 기능도 확인하기
비밀번호 입력창도 함께 확인했습니다.
기본적으로 type=“password”인 입력창은 Replay에서 보호되지만, KOIN에는 입력한 비밀번호를 확인할 수 있도록 type=“text”로 바꾸는 보기 기능이 있었습니다.
<input type={isPasswordVisible ? "text" : "password"} />사용자가 비밀번호 보기 버튼을 누르면 일반적인 text input으로 바뀌기 때문에 기본 마스킹만으로는 충분하지 않을 수 있었습니다.
그래서 비밀번호 보기 기능이 있는 입력창에도 명시적으로 Replay 마스킹을 적용했습니다.
이후에는 입력 타입이 바뀌더라도 Replay에서는 비밀번호 값이 계속 가려지도록 했습니다.
어떤 데이터를 수집할까
Session Replay를 정리하면서 Sentry SDK도 10.43.0에서 10.74.0으로 업그레이드했고, 기존 sendDefaultPii 설정을 dataCollection으로 변경했습니다.
이 과정에서 Sentry가 기본적으로 수집하는 데이터도 다시 확인했습니다.
개인정보 전송을 줄이려면 모든 항목을 끄는 것이 가장 단순하지만, 그렇게 하면 실제 오류를 조사할 때 필요한 정보도 함께 사라집니다.
예를 들어 Sentry에서 오류를 조사할 때는 다음과 같은 정보가 유용했습니다.
- 몇 명의 사용자가 영향을 받았는지
- 어떤 API 요청에서 문제가 발생했는지
- Request Body에 어떤 값이 전달됐는지
- 어떤 Query Parameter를 가진 요청이었는지
그래서 모든 데이터를 끄기보다 사용 목적이 명확하지 않거나 민감도가 높은 정보부터 제한하기로 했습니다.
Cookie를 전송하지 않고, HTTP Header에서는 인증정보와 이전 페이지 정보가 포함될 가능성이 높은 authorization, referer를 제외했습니다.
dataCollection: {
  cookies: false,
  httpHeaders: {
    deny: ['authorization', 'referer'],
  },

  // 디버깅에 필요한 항목은 유지
  userInfo: true,
  httpBodies: true,
  urlQueryParams: true,
}
반면 영향을 받은 사용자 수나 API 요청을 분석하는 데 필요한 userInfo, httpBodies, urlQueryParams는 유지했습니다.
모든 데이터를 최소화하기보다, 각 데이터가 왜 필요한지 확인하고 남길 것과 버릴 것을 구분하는 방식으로 수집 범위를 조정했습니다.
애초에 URL에 넣지 않기
수집 범위를 확인하면서 Sentry 설정만으로 해결하기보다 서비스 구조 자체를 바꾸는 편이 나은 부분도 있었습니다.
KOIN의 아이디 찾기 기능에서는 인증이 끝난 뒤 찾은 로그인 아이디를 다음 페이지로 전달하기 위해 Query String을 사용하고 있었습니다.
/find-id/result?userId=example123URL에 로그인 아이디가 포함되면 브라우저 주소창뿐 아니라 여러 경로를 통해 해당 값이 남을 수 있습니다.
URL
 ├─ Browser History
 ├─ Referer
 ├─ Sentry Request Context
 └─ Session Replay
Sentry에서 Query Parameter 수집 자체를 끌 수도 있었지만, 다른 오류를 분석할 때는 Query Parameter가 필요한 경우도 있었습니다.
그래서 모든 Query Parameter를 제거하기보다, 로그인 아이디를 애초에 URL에 넣지 않도록 변경했습니다.
아이디 찾기 결과는 Query String 대신 sessionStorage를 통해 전달하도록 수정했습니다.
sessionStorage.setItem(STORAGE_KEY.FOUND_LOGIN_ID, loginId);이후 결과 페이지에서는 저장된 값을 읽어 화면에 표시하도록 했습니다.
변경 전

/find-id/result?userId=example123


변경 후

/find-id/result
        │
        └─ sessionStorage
             └─ FOUND_LOGIN_ID
이렇게 하면 로그인 아이디가 URL, Referer, Sentry Request Context, Session Replay 등에 함께 남는 문제를 한 번에 줄일 수 있었습니다.
Data Scrubbing으로 한 번 더 걸러내기
애플리케이션과 SDK에서 수집 범위를 정리한 뒤에는 Sentry Organization 설정도 함께 확인했습니다.
먼저 Security & Privacy에서 Enhanced Privacy를 활성화했습니다.
Sentry 내부에서는 문제 분석에 필요한 데이터를 유지하면서, Slack이나 이메일처럼 외부 알림 채널로 전달될 때 개인정보나 소스코드가 불필요하게 노출되는 범위를 줄이기 위해 사용했습니다.
이어 Data Scrubbing에서는 Require Using Default Scrubbers를 활성화했습니다.
이를 통해 password, secret, API key처럼 일반적으로 민감한 값은 Sentry의 기본 Scrubber를 통해 한 번 더 제거하도록 했습니다.
그리고 KOIN에서 실제로 사용하는 개인정보 필드도 Global Sensitive Fields에 추가했습니다.
login_id
phone_number
student_number
email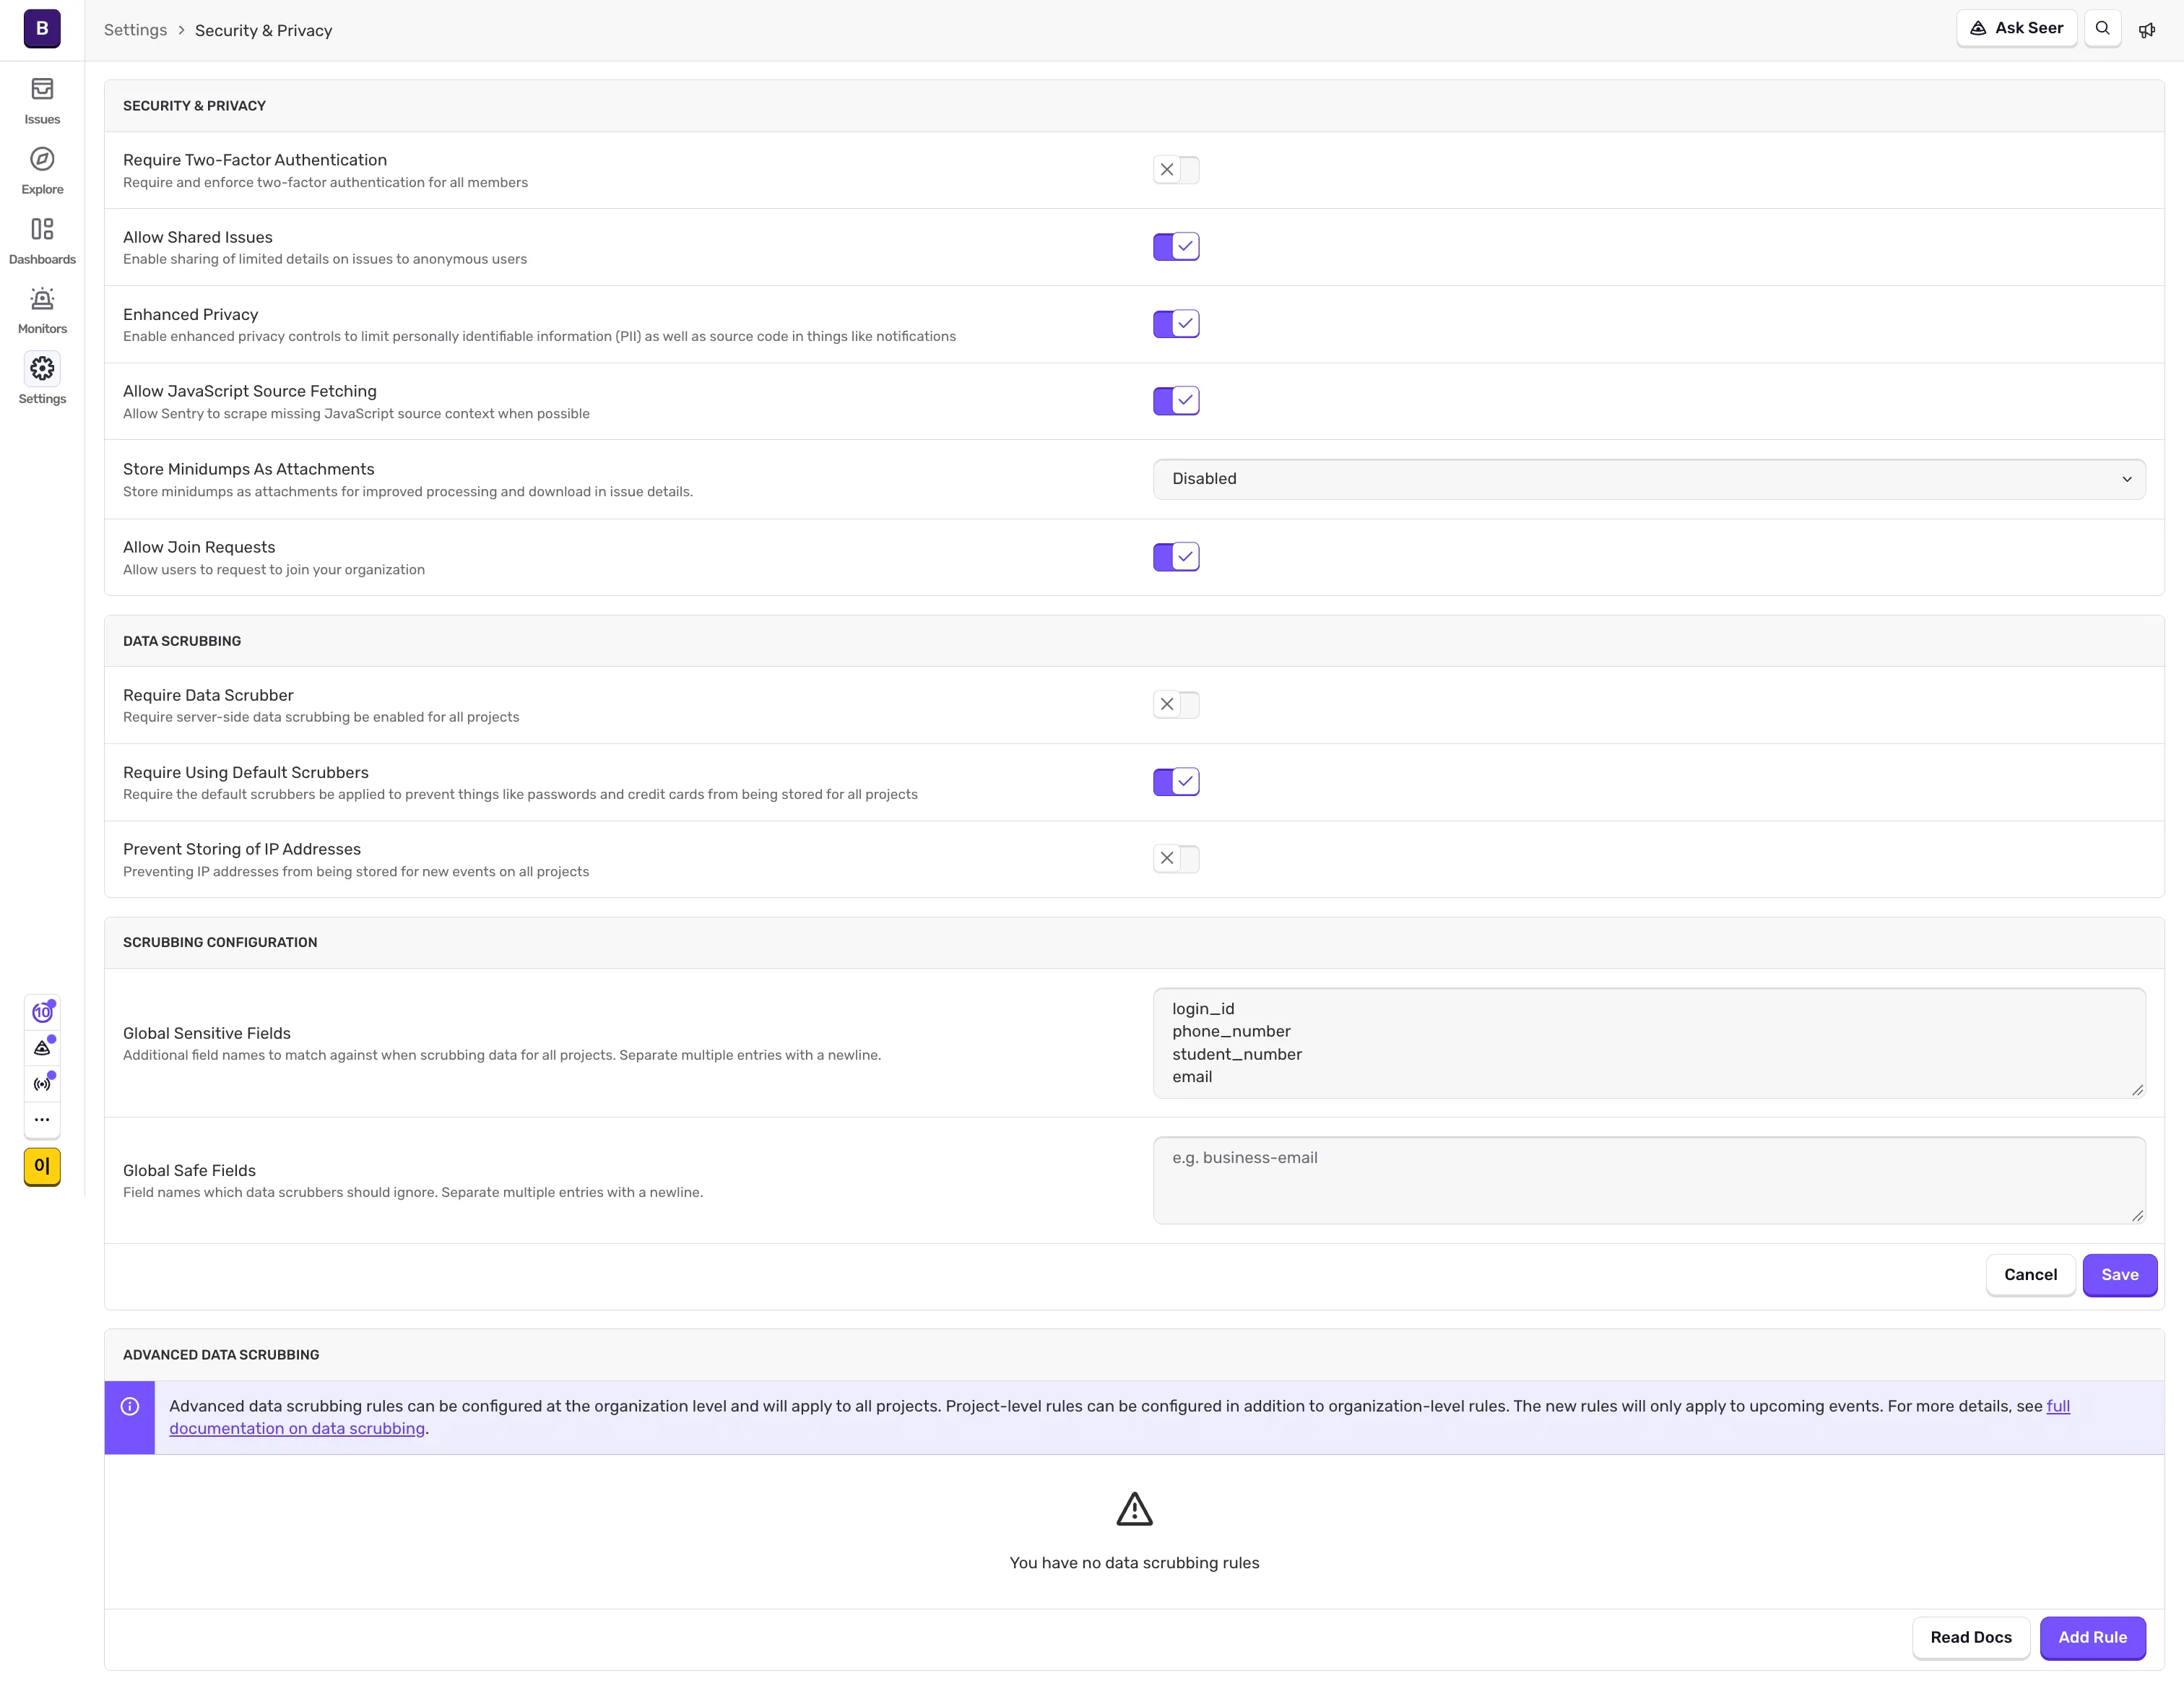
name은 Global Sensitive Fields에 추가하지 않았습니다.
Sentry의 필드 매칭 특성상 name을 등록하면 filename, hostname, username처럼 디버깅에 필요한 다른 필드까지 함께 가려질 가능성이 있었기 때문입니다.
실명 필드까지 서버 측에서 추가로 처리할 필요가 생기면 Global Sensitive Fields에 넓게 등록하기보다 Advanced Data Scrubbing에서 정확한 필드만 지정하는 방향으로 남겨두었습니다.
IP 주소는 유지한 이유
Data Scrubbing 설정 중 Prevent Storing of IP Addresses는 활성화하지 않았습니다.
앞선 글에서 Dashboard와 Alert를 구성하면서 Event 수뿐 아니라 영향을 받은 사용자 수도 함께 확인하도록 했습니다.
예를 들어 아래 두 상황은 Event 수는 같지만 의미가 다릅니다.
100 events / 1 user

vs.

100 events / 100 users
한 사용자의 반복 오류인지, 여러 사용자에게 동시에 영향을 주는 문제인지에 따라 대응 우선순위가 달라질 수 있습니다.
현재 구성에서는 별도의 명확한 사용자 식별 정보가 없는 상황에서도 IP를 기반으로 Users affected를 계산하는 부분이 있어, IP 저장을 차단하면 이 지표를 활용하기 어려워집니다.
그래서 userInfo와 IP 저장은 유지했습니다.
대신 Cookie, Authorization Header, Referer처럼 다른 방법으로 대체할 수 있거나 굳이 수집할 필요가 없는 데이터부터 제한했습니다.
한 곳에서 해결하려 하지 않기
정리하고 보니 개인정보 처리는 하나의 Sentry 옵션으로 끝나는 문제가 아니었습니다.
애플리케이션
└─ 민감정보를 불필요하게 URL 등에 넣지 않기
        │
        ▼
Sentry SDK
├─ dataCollection으로 수집 범위 제한
├─ beforeSend / beforeSendLog
└─ Session Replay 선택적 마스킹
        │
        ▼
Sentry
├─ Data Scrubbing
└─ Enhanced Privacy
애플리케이션에서는 민감정보가 URL과 같은 위치에 들어가지 않도록 했고, SDK에서는 전송 범위를 제한하고 JWT 같은 값을 전송 전에 제거했습니다. Session Replay에서는 화면에 표시되는 개인정보를 선택적으로 가렸습니다.
그 이후에도 놓치는 값이 있을 수 있기 때문에 Sentry의 Data Scrubbing을 마지막 방어선으로 두었습니다.
각 단계의 역할은 다음과 같이 정리할 수 있었습니다.
| 단계 | 역할 |
|---|---|
| 애플리케이션 | 민감정보가 불필요한 위치에 들어가지 않도록 설계 |
dataCollection |
SDK가 수집하는 데이터의 범위 제한 |
beforeSend / beforeSendLog |
민감정보를 전송 전에 제거 |
| Session Replay masking | 화면에서 노출되는 개인정보를 선택적으로 제거 |
| Data Scrubbing | Sentry 서버에 도착한 데이터를 추가 마스킹 |
| Enhanced Privacy | 외부 알림에서의 노출 범위 축소 |
특히 Data Scrubbing이 있다고 해서 애플리케이션에서의 처리를 생략할 수 있는 것은 아니었습니다.
Data Scrubbing은 Sentry에 전송된 이후 적용되는 안전망이고, beforeSend나 dataCollection은 데이터를 전송하기 전에 제어합니다.
가능하다면 가장 앞단에서 불필요한 데이터를 만들지 않거나 보내지 않고, 뒤쪽의 Scrubbing은 예상하지 못한 상황을 위한 추가 방어선으로 두는 방향으로 정리했습니다.
더 많이 수집하는 것이 항상 좋은 것은 아니었다
Sentry로 전환하면서 처음에는 GlitchTip보다 더 많은 기능을 사용할 수 있다는 점에 집중했습니다.
Session Replay, Trace, Logs를 활용하면서 실제로 문제를 분석하기는 훨씬 쉬워졌습니다.
하지만 그만큼 어떤 데이터를 수집할 것인지 결정하는 것도 모니터링 환경을 운영하는 일의 일부라는 것을 알게 되었습니다.
JWT가 실제 Logs에 들어온 것을 확인한 뒤 전송 전에 마스킹했고, Session Replay에서는 필요한 화면 문맥을 유지하면서 개인정보만 선택적으로 가렸습니다. 모든 PII 수집을 끄는 대신 Cookie와 민감한 Header부터 제한했고, 아이디 찾기처럼 애플리케이션 자체에서 개선할 수 있는 부분은 Sentry 설정이 아닌 서비스 구조를 변경했습니다.
그리고 그 위에 Data Scrubbing을 추가해 놓칠 수 있는 부분을 한 번 더 방어하도록 했습니다.
결국 이번 전환에서 바뀐 것은 모니터링 도구만은 아니었습니다.
Self-hosted 환경에서는 모니터링 서버를 어떻게 운영할 것인가가 주요 고민이었다면, SaaS로 전환한 뒤에는 어떤 데이터를 보내고, 어떤 신호를 믿고, 어디까지 보관할 것인가가 더 중요한 운영 과제가 되었습니다.
처음에는 EC2에 있던 GlitchTip을 어디로 옮길지를 고민하면서 시작했지만, 결과적으로 Sentry를 도입하고 운영하는 과정에서 모니터링 환경 자체를 다시 정의하게 되었습니다.